지시 원문, 분석, 과정, 자문, 결과를 단계(Phase)로 묶어 시간순으로 기록합니다. 단계마다 목적과 결과를 적고, 작업마다 목적 태그를 붙였습니다. 민감정보(IP, 토큰, 키 등)는 기록하지 않습니다.
Titanic · gender 기준선 (LB)
0.76555
v1 Soft Voting (LB)
0.76315
v2 WCG 규칙 (LB) · 최고
0.79904
v3 WCG + Voting (LB)
0.77511
Spaceship s1 CatBoost (LB)
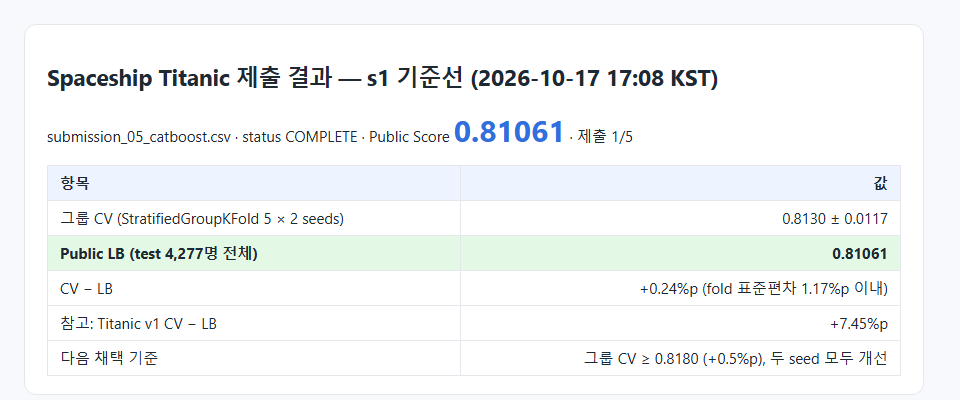
0.81061
Spaceship s2 E2 앙상블 (LB) · 최고
0.81084
목적별 보기
PHASE 0
프로젝트 기반 설정
목적공유할 수 있는 작업 기록 체계, 외부 자문 도구(Jev, astra, sol), 프로젝트 목표를 준비한다.
결과CLAUDE.md 규칙, history.html, 민감정보 검사, 자문 헬퍼 완성
2026-10-17 14:15 → 14:22 (KST)
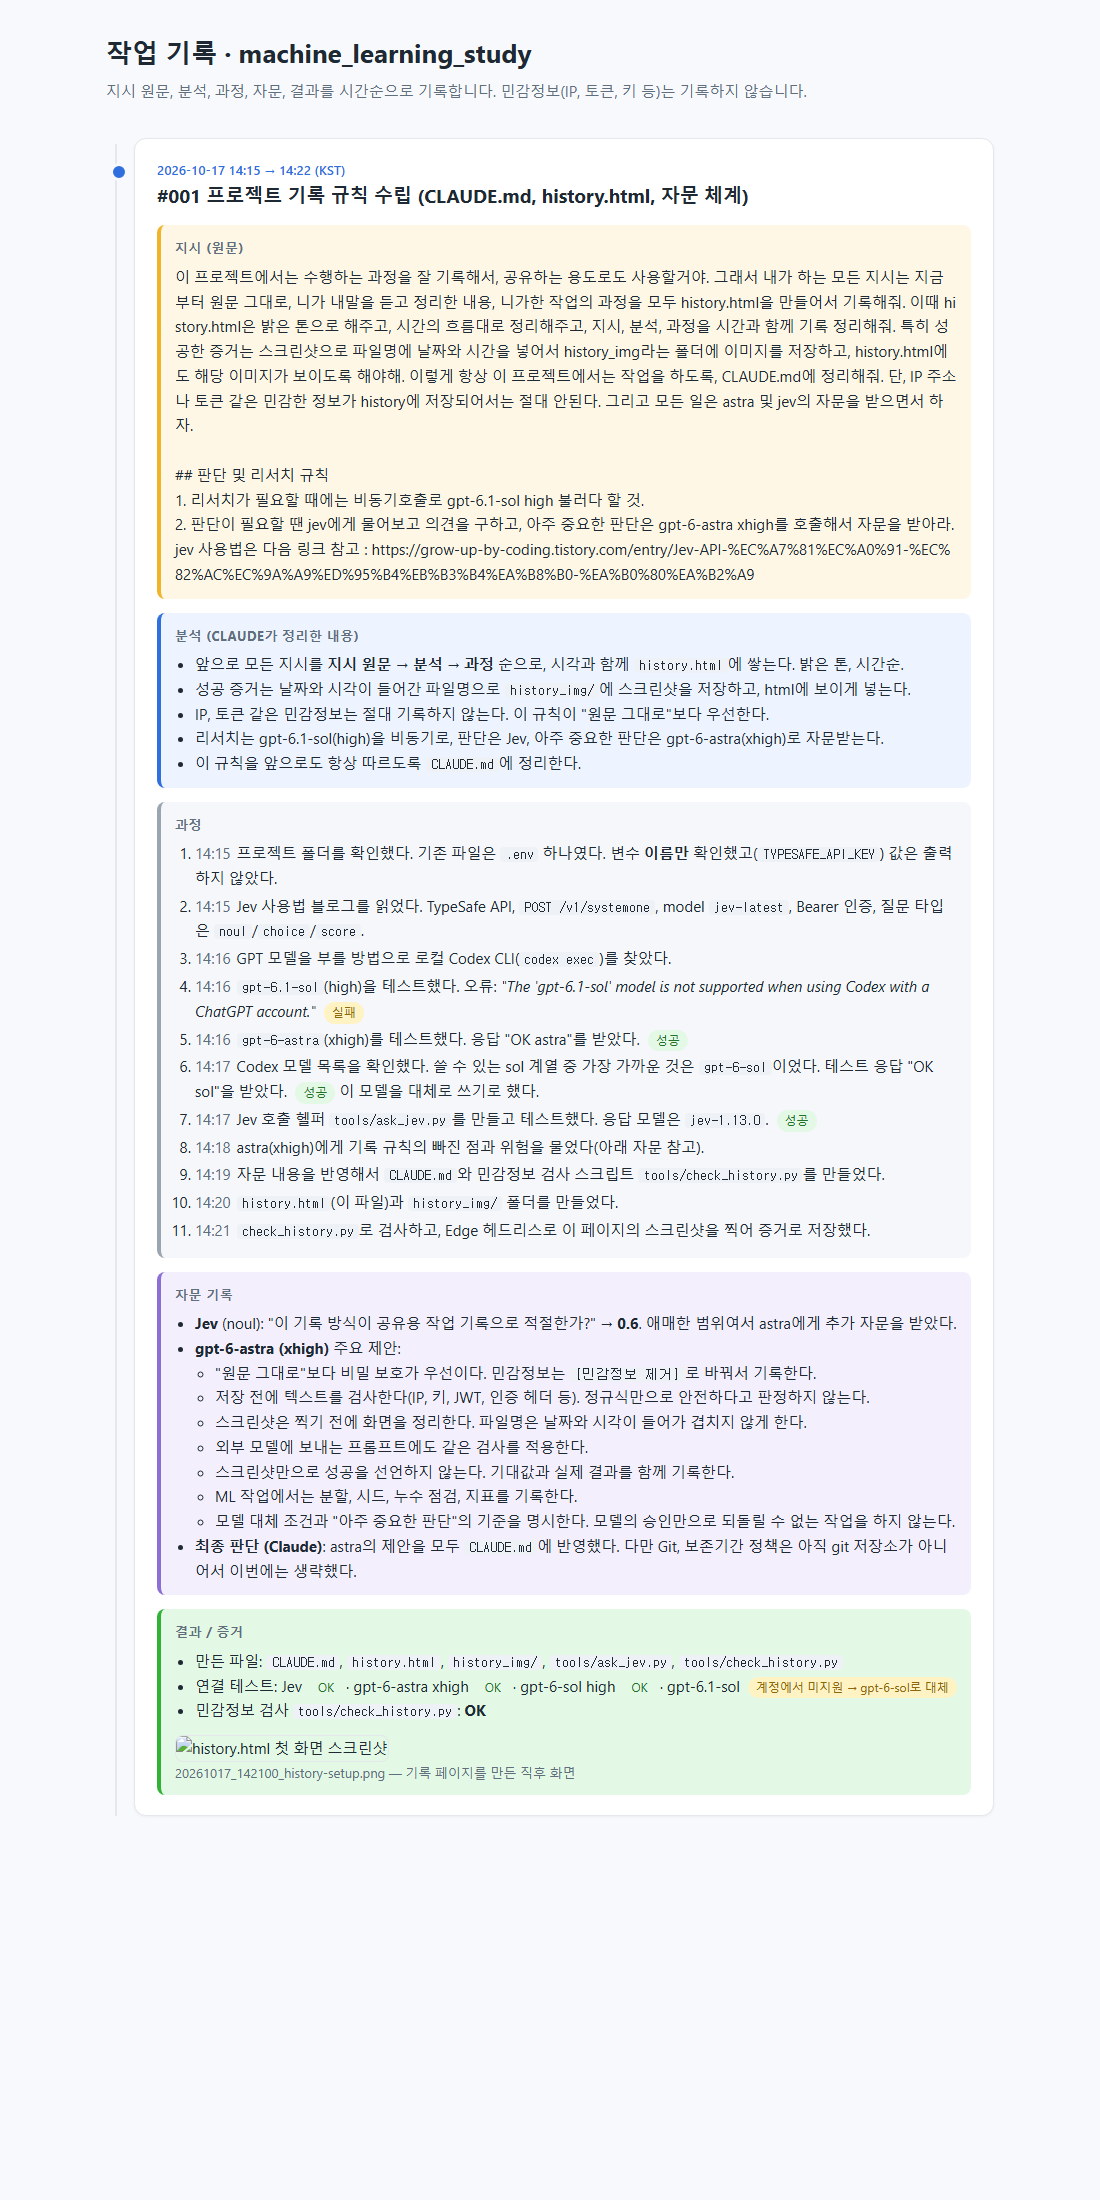
#001 프로젝트 기록 규칙 수립 (CLAUDE.md, history.html, 자문 체계)
설정·환경리서치자문·판단기록·문서화
지시 (원문)
이 프로젝트에서는 수행하는 과정을 잘 기록해서, 공유하는 용도로도 사용할거야. 그래서 내가 하는 모든 지시는 지금부터 원문 그대로, 니가 내말을 듣고 정리한 내용, 니가한 작업의 과정을 모두 history.html을 만들어서 기록해줘. 이때 history.html은 밝은 톤으로 해주고, 시간의 흐름대로 정리해주고, 지시, 분석, 과정을 시간과 함께 기록 정리해줘. 특히 성공한 증거는 스크린샷으로 파일명에 날짜와 시간을 넣어서 history_img라는 폴더에 이미지를 저장하고, history.html에도 해당 이미지가 보이도록 해야해. 이렇게 항상 이 프로젝트에서는 작업을 하도록, CLAUDE.md에 정리해줘. 단, IP 주소나 토큰 같은 민감한 정보가 history에 저장되어서는 절대 안된다. 그리고 모든 일은 astra 및 jev의 자문을 받으면서 하자.
## 판단 및 리서치 규칙
1. 리서치가 필요할 때에는 비동기호출로 gpt-6.1-sol high 불러다 할 것.
2. 판단이 필요할 땐 jev에게 물어보고 의견을 구하고, 아주 중요한 판단은 gpt-6-astra xhigh를 호출해서 자문을 받아라.
jev 사용법은 다음 링크 참고 : https://grow-up-by-coding.tistory.com/entry/Jev-API-%EC%A7%81%EC%A0%91-%EC%82%AC%EC%9A%A9%ED%95%B4%EB%B3%B4%EA%B8%B0-%EA%B0%80%EA%B2%A9
분석 (Claude가 정리한 내용)
앞으로 모든 지시를 지시 원문 → 분석 → 과정 순으로, 시각과 함께 history.html에 쌓는다. 밝은 톤, 시간순.
성공 증거는 날짜와 시각이 들어간 파일명으로 history_img/에 스크린샷을 저장하고, html에 보이게 넣는다.
IP, 토큰 같은 민감정보는 절대 기록하지 않는다. 이 규칙이 "원문 그대로"보다 우선한다.
리서치는 gpt-6.1-sol(high)을 비동기로, 판단은 Jev, 아주 중요한 판단은 gpt-6-astra(xhigh)로 자문받는다.
이 규칙을 앞으로도 항상 따르도록 CLAUDE.md에 정리한다.
과정
설정·환경14:15프로젝트 폴더를 확인했다. 기존 파일은 .env 하나였다. 변수 이름만 확인했고(TYPESAFE_API_KEY) 값은 출력하지 않았다.
리서치14:15Jev 사용법 블로그를 읽었다. TypeSafe API, POST /v1/systemone, model jev-latest, Bearer 인증, 질문 타입은 noul/choice/score.
설정·환경14:16GPT 모델을 부를 방법으로 로컬 Codex CLI(codex exec)를 찾았다.
설정·환경14:16gpt-6.1-sol(high)을 테스트했다. 오류: "The 'gpt-6.1-sol' model is not supported when using Codex with a ChatGPT account."실패
설정·환경14:16gpt-6-astra(xhigh)를 테스트했다. 응답 "OK astra"를 받았다. 성공
설정·환경14:17Codex 모델 목록을 확인했다. 쓸 수 있는 sol 계열 중 가장 가까운 것은 gpt-6-sol이었다. 테스트 응답 "OK sol"을 받았다. 성공 이 모델을 대체로 쓰기로 했다.
설정·환경14:17Jev 호출 헬퍼 tools/ask_jev.py를 만들고 테스트했다. 응답 모델은 jev-1.13.0. 성공
자문·판단14:18astra(xhigh)에게 기록 규칙의 빠진 점과 위험을 물었다(아래 자문 참고).
기록·문서화14:19자문 내용을 반영해서 CLAUDE.md와 민감정보 검사 스크립트 tools/check_history.py를 만들었다.
기록·문서화14:20history.html(이 파일)과 history_img/ 폴더를 만들었다.
기록·문서화14:21check_history.py로 검사하고, Edge 헤드리스로 이 페이지의 스크린샷을 찍어 증거로 저장했다. 첫 검사에서 증거 이미지 파일명이 "긴 비밀값"으로 오탐되어, 날짜 형식의 파일명은 검사에서 제외하도록 스크립트를 고쳤다. 다시 검사해서 OK를 확인했고, 스크린샷에 민감정보가 없는 것도 눈으로 확인했다. (스크린샷 안의 이미지 칸이 비어 있는 것은 이미지를 만들기 전에 찍었기 때문이다.)
자문 기록
Jev (noul): "이 기록 방식이 공유용 작업 기록으로 적절한가?" → 0.6. 애매한 범위여서 astra에게 추가 자문을 받았다.
gpt-6-astra (xhigh) 주요 제안:
"원문 그대로"보다 비밀 보호가 우선이다. 민감정보는 [민감정보 제거]로 바꿔서 기록한다.
저장 전에 텍스트를 검사한다(IP, 키, JWT, 인증 헤더 등). 정규식만으로 안전하다고 판정하지 않는다.
스크린샷은 찍기 전에 화면을 정리한다. 파일명은 날짜와 시각이 들어가 겹치지 않게 한다.
외부 모델에 보내는 프롬프트에도 같은 검사를 적용한다.
스크린샷만으로 성공을 선언하지 않는다. 기대값과 실제 결과를 함께 기록한다.
ML 작업에서는 분할, 시드, 누수 점검, 지표를 기록한다.
모델 대체 조건과 "아주 중요한 판단"의 기준을 명시한다. 모델의 승인만으로 되돌릴 수 없는 작업을 하지 않는다.
최종 판단 (Claude): astra의 제안을 모두 CLAUDE.md에 반영했다. 다만 Git, 보존기간 정책은 아직 git 저장소가 아니어서 이번에는 생략했다.
결과 / 증거
만든 파일: CLAUDE.md, history.html, history_img/, tools/ask_jev.py, tools/check_history.py
연결 테스트: Jev OK · gpt-6-astra xhigh OK · gpt-6-sol high OK · gpt-6.1-sol 계정에서 미지원 → gpt-6-sol로 대체
민감정보 검사 tools/check_history.py: OK
20261017_142100_history-setup.png — 기록 페이지를 만든 직후 화면
2026-10-17 14:24 → 14:26 (KST)
#002 프로젝트 목표 설정: Kaggle 문제를 ML/DL로 해석하고 모델링
설정·환경리서치자문·판단기록·문서화
지시 (원문)
이 프로젝트에서는 kaggle competition 혹은 dataset을 머신러닝 혹은 딥러닝 기법으로 해석 및 모델을 만들고자 한다.
분석
프로젝트의 큰 목표를 정한 지시다. 아직 어떤 대회나 데이터셋을 할지는 정하지 않았다.
해야 할 일: 로컬 환경을 확인하고, 후보를 리서치하고, 목표를 CLAUDE.md에 적는다.
과정
설정·환경14:24로컬 환경을 확인했다. Windows, GPU 없음, Python 3.11, TensorFlow 2.20이 있다. scikit-learn, LightGBM, PyTorch, Kaggle CLI는 없다. Kaggle 인증도 설정돼 있지 않다.
리서치14:25후보 리서치를 비동기로 실행했다. gpt-6.1-sol이 미지원이라 규칙대로 gpt-6-sol(high, 웹 검색)로 다시 호출했다.
자문·판단14:25Jev에게 시작 방식을 물었다(아래 자문).
기록·문서화14:26CLAUDE.md에 "0. 프로젝트 목표"와 환경 정보를 추가했다.
자문 기록
Jev (choice): 시작 방식으로 표 형식 ML / DL / 단계적 중 무엇이 좋은가 → 단계적(0.36), 표 형식 ML(0.33), DL(0.31). 확신도가 0.04로 낮아서 판단을 보류했다.
Jev (noul): 구체적인 대회를 사용자에게 먼저 물어야 하는가 → 0.85. 사용자의 선택을 기다리기로 했다.
gpt-6-sol 리서치 요약 (2026-10-17 기준):
진행 중인 대회: Playground S6E10 Airline Satisfaction(ROC-AUC, 10/31 마감), Housing Affordability(RMSE), Soil Grain Size(이미지, EMD), Memecoins(PnL).
Kaggle Titanic은 승객의 생존 여부를 맞히는 이진분류 문제다. train 891행, test 418행, 평가는 accuracy.
할 일: 환경 구성 → 데이터 받기 → EDA → 특징 공학 → 검증 전략 → 모델 비교 → 제출 파일.
CPU만으로 충분한 규모다. DL(MLP)은 비교 실험으로만 넣는다.
과정
설정·환경14:27프로젝트 전용 가상환경 .venv를 만들고 sklearn, LightGBM, XGBoost, CatBoost, optuna, kaggle, jupyter 설치를 시작했다. 설치가 오래 걸려서 백그라운드로 돌렸다.
자문·판단14:28astra(xhigh)에게 Titanic 진행 계획을 물었다(아래 자문).
설정·환경14:39폴더 구조를 만들었다: titanic/{data/raw, data/processed, notebooks, src, reports/figures, submissions}. .gitignore에는 .env, .venv, 원본 데이터, kaggle.json을 넣었다.
모델링·검증14:39titanic/src/features.py를 작성했다. 행 단위 특징(Title, FamilySize, IsAlone, Deck, HasCabin, TicketPrefix, AgeMissing, Sex×Pclass)과 fold-safe 변환기(Ticket 집단 크기, Title별 Age 대치, FarePerPerson, 드문 접두어 묶기)를 넣었다. 처음에는 학습 데이터 여부를 행 index로 판정했는데, train과 test의 index가 겹치는 버그를 발견해서 PassengerId 기준으로 고쳤다.
모델링·검증14:40titanic/src/train.py를 작성했다. 모델은 Dummy → Logistic → DecisionTree → RF/ExtraTrees → LightGBM/XGBoost/CatBoost → MLP → Soft Voting 순으로 비교한다. 검증은 StratifiedKFold(5)를 seed 3개로 반복하고, Ticket 기준 StratifiedGroupKFold(5)도 함께 본다.
자문 기록 — gpt-6-astra (xhigh) 계획 제안 요약
구조: 데이터, 노트북, src, 결과, 제출 파일을 분리한다. 원본 데이터는 Git에서 제외한다.
EDA: 생존 비율, 결측률, Sex·Pclass·Embarked별 생존율, Age·Fare 분포를 본다. 작은 집단의 생존 비율은 과하게 해석하지 않는다.
특징: Title, FamilySize, IsAlone, Deck, Ticket 접두어와 집단 크기, log Fare, Age 결측 표시를 묶음별로 추가하면서 CV 변화를 본다.
검증과 누수: Stratified 5-fold를 고정 seed로 쓰고 Ticket 기준 GroupKFold와 비교한다. 대치, 인코딩, 집단 통계는 학습 fold로만 fit한다. 기본 실험에서는 test 정보를 쓰지 않는다.
모델 순서: 다수 클래스 → 로지스틱 → 트리 → 부스팅 → 앙상블. 평균과 표준편차, 시간을 기록한다.
주의: 데이터가 작아서 CV와 리더보드 점수 차이가 크다. 모델은 CV로 고르고 제출 횟수는 제한한다.
DL(MLP): 학습과 비교 목적으로는 넣을 가치가 있다. 트리보다 좋을 거라고 기대하지는 않는다.
최종 판단 (Claude): 위 제안을 그대로 코드 구조와 검증 방식에 반영했다.
결과 / 남은 일
코드와 구조를 준비했다. 사용자에게 Kaggle 규칙 동의와 API 토큰 설정을 요청했다(토큰은 채팅에 붙이지 말고 .env에 직접 넣도록 안내).
PHASE 2
데이터 · EDA · 기준 모델
목적데이터를 받아 EDA를 하고 모델 9개를 같은 CV로 비교한다.
결과Soft Voting CV 0.8376, EDA 핵심 신호(성별, 등급, 호칭) 확인
2026-10-17 14:43 → 15:17 (KST)
#004 Titanic 데이터 다운로드 · EDA · 모델 비교(CV)
설정·환경데이터EDA모델링·검증기록·문서화자문·판단
지시 (원문)
완료.
분석
사용자가 Kaggle 규칙 동의와 토큰 설정을 마쳤다. .env에 KAGGLE_API_TOKEN 변수가 있는 것만 확인했고, 값은 보지도 기록하지도 않았다.
할 일: 데이터 다운로드 → EDA → CV 비교 → 제출 파일 생성.
과정
설정·환경14:43패키지 설치가 16분째 끝나지 않았다. 확인해 보니 -q 옵션 때문에 진행 상황이 보이지 않았고, venv에는 아무것도 설치되지 않은 상태였다. 문제
설정·환경14:50로그를 켜고 다시 설치하자 원인이 보였다. 네트워크가 불안정해서 CatBoost 휠(100MB) 다운로드가 계속 끊겼다. CatBoost를 빼고 재시도 옵션(--retries 10 --timeout 60)을 붙여 백그라운드로 다시 설치했다.
데이터14:52설치를 기다리는 동안 tools/kaggle_download.py를 만들었다. Kaggle API를 직접 호출하고, 토큰은 .env에서 읽기만 하고 출력하지 않는다. 받은 파일: train.csv(891행), test.csv(418행), gender_submission.csv. 성공
설정·환경15:12CatBoost를 뺀 패키지 설치가 끝났다(sklearn, LightGBM 4.7, XGBoost 3.2, optuna, kaggle 등). CatBoost는 백그라운드에서 따로 재시도 중이다.
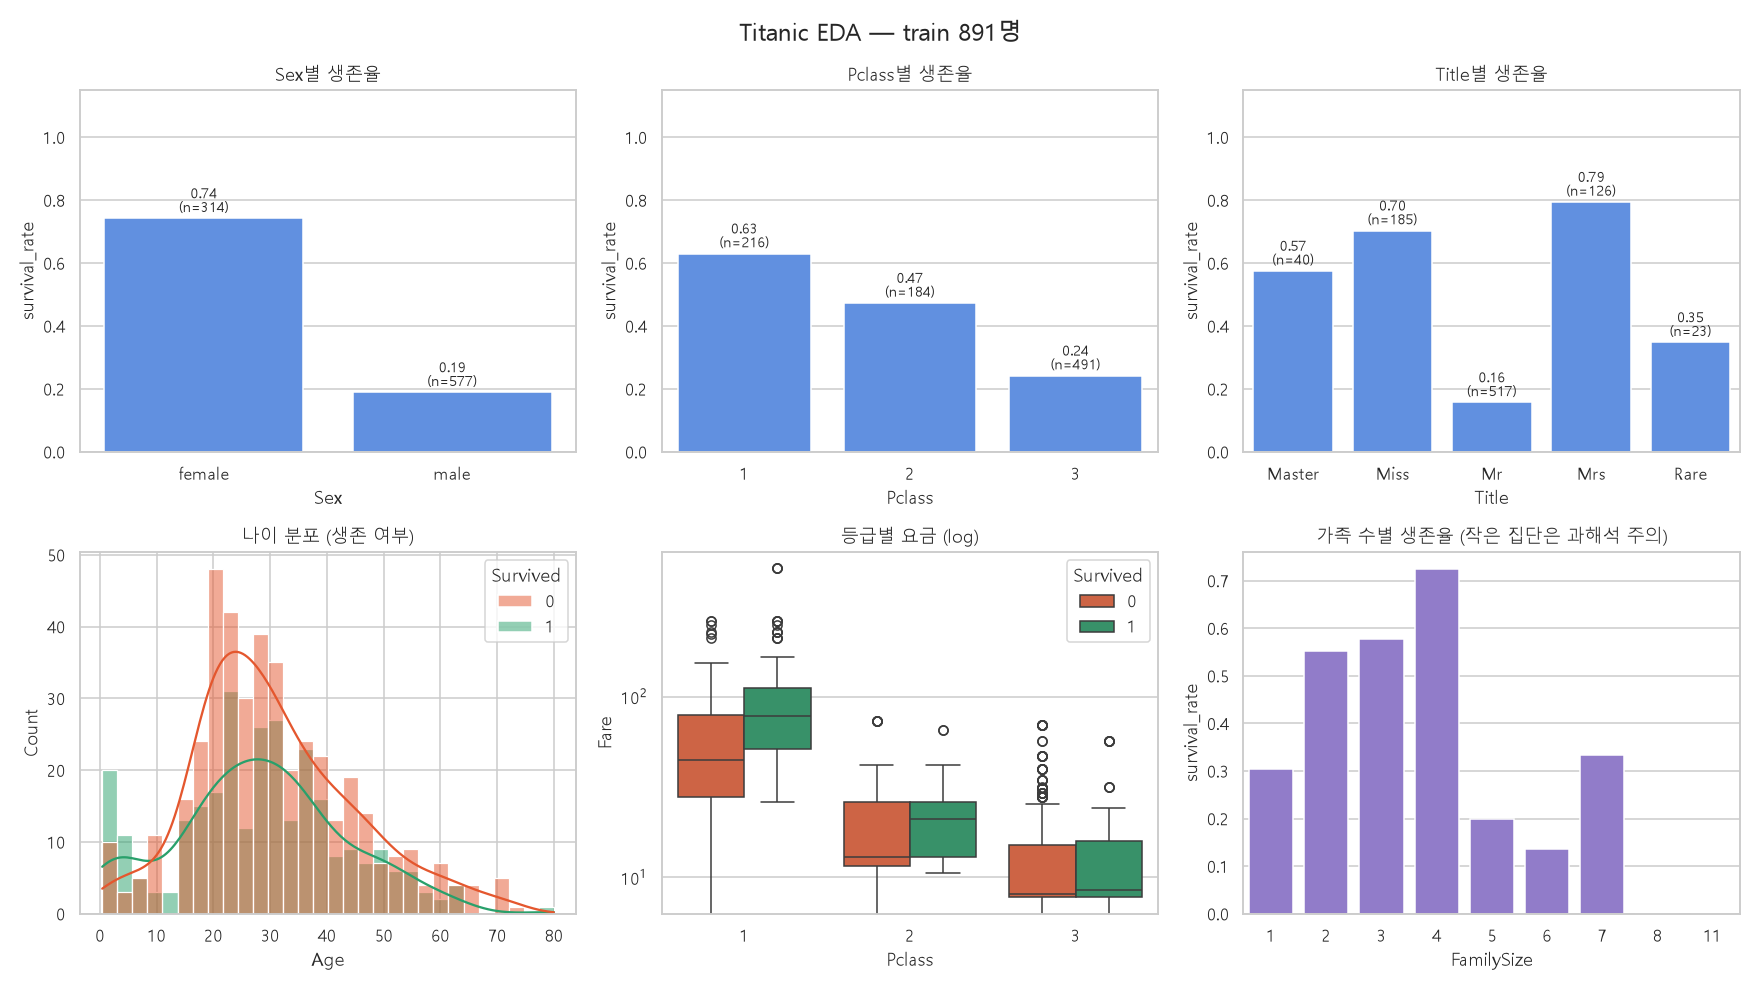
EDA15:13titanic/src/eda.py를 실행했다. 요약은 reports/eda_summary.md, 그림은 reports/figures/에 저장했다. 성공
모델링·검증15:13train.py가 CatBoost 없이도 돌도록 import를 선택적으로 바꿨다.
모델링·검증15:13–15:16모델 9개의 CV를 비교했다(약 3분). 최고 모델로 제출 파일을 만들었다. 성공
기록·문서화15:16plot_cv.py로 CV 결과 그래프를 그리고, 증거 이미지를 history_img/에 저장했다.
EDA 핵심 발견
전체 생존율은 38.4%다. 전원 사망으로 예측해도 정확도가 61.6%이므로, 이 값이 넘어야 할 기준선이다.
결측률(train/test): Age 19.9%/20.6%, Cabin 77.1%/78.2%, Embarked 0.2%/0%, Fare 0%/0.2%. train과 test의 분포는 비슷하다.
성별이 가장 강한 신호다. 여성 74.2%, 남성 18.9%. 성별과 등급을 같이 보면 여성 1·2등석은 92% 이상, 남성 2·3등석은 14~16%다.
등급: 1등석 63%, 2등석 47%, 3등석 24%. Title: Mr 15.7%, Master(남자아이) 57.5%. 같은 남성이어도 아이는 생존율이 높았다.
가족 수: 혼자 30.4%, 2~4명 57.9%, 5명 이상 16.1%. 중간 크기 가족의 생존율이 가장 높다. 다만 집단이 작아서 과하게 해석하면 안 된다.
Cabin 기재 여부: 기재 없음(U)은 29.9%, 기재 있음은 대체로 47~76%다. 이 차이는 등급 효과가 섞인 결과일 가능성이 크다.
20261017_151644_titanic-eda-overview.png — 성별·등급·Title별 생존율, 나이 분포, 등급별 요금, 가족 수별 생존율
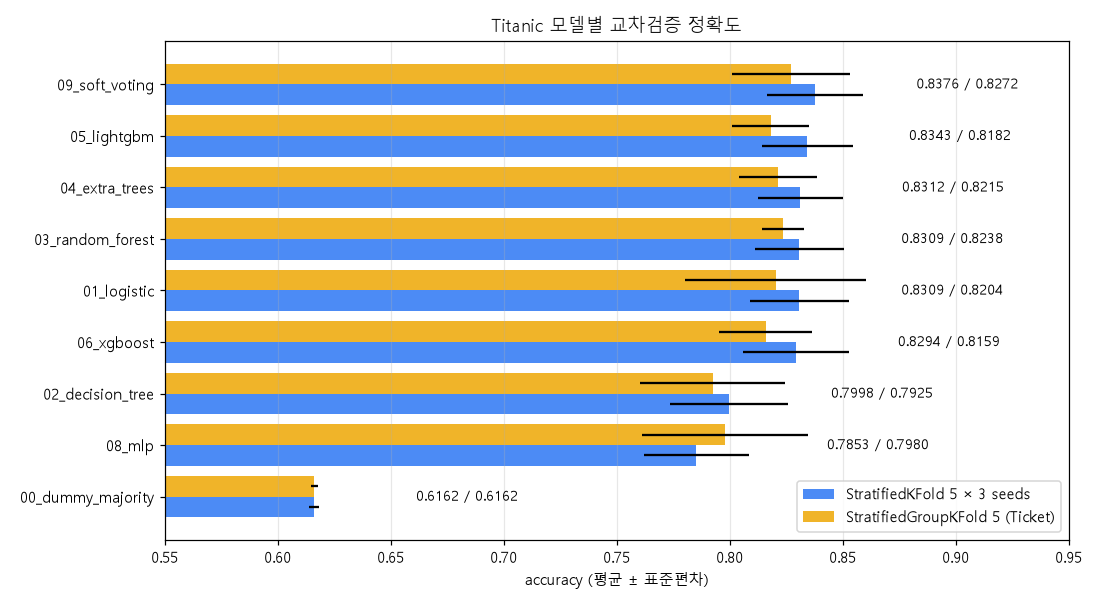
결과 / 증거 — 교차검증 정확도 (평균 ± 표준편차)
검증 방식: StratifiedKFold 5-fold를 seed 3개(42, 7, 2026)로 반복(총 15 fold)했다. 비교용으로 Ticket 기준 StratifiedGroupKFold 5-fold도 돌렸다. 전처리는 모두 Pipeline 안에서 학습 fold로만 fit했다.
1위 Soft Voting(LR+RF+XGB): CV 0.8376 ± 0.0212, GroupCV 0.8272. 2위 LightGBM: 0.8343 / 0.8182. RF, ExtraTrees, Logistic은 약 0.831이다.
MLP(DL 비교군): 0.7853. astra의 예상대로 이 크기의 표 데이터에서는 트리와 선형 모델보다 낮았다.
상위 모델들의 차이(약 0.007)는 표준편차(약 0.02)보다 훨씬 작다. 통계적으로 의미 있는 우열이라고 보기 어렵다.
GroupCV가 일반 CV보다 0.005~0.016 낮다. 같은 티켓을 쓴 일행의 정보가 일반 CV에서 조금 유리하게 작용한 것으로 보인다.
Jev (choice, 15:18): 다음 단계로 무엇이 좋은가 → 먼저 개선(0.61), 사용자에게 제출 여부 묻기(0.28), 바로 제출(0.11).
최종 판단 (Claude): Kaggle 제출은 사용자 계정으로 공개 리더보드에 남는 외부 작업이다. 그래서 바로 제출하지 않고, 개선 계획과 함께 사용자에게 제출 여부를 묻기로 했다.
기타: 민감정보 검사 스크립트가 파일 경로를 비밀값으로 오탐해서, 짧은 소문자 단어로만 된 경로는 예외로 처리했다. 실제 토큰 형태의 문자열은 계속 잡히는 것을 확인했다.
PHASE 3
첫 제출과 격차 진단
목적리더보드 기준점을 얻고, CV와 LB의 격차 원인을 제출 없이 진단한다.
결과LB 0.76315. 특징 구성은 원인이 아님. WCG 규칙 후보 발견
2026-10-17 15:21 → 15:39 (KST)
#005 Kaggle 첫 제출 (0.76315) · CV-LB 격차 진단 · WCG 규칙
제출자문·판단모델링·검증
지시 (원문)
3번으로 진행해.
분석
앞서 제시한 3번 "지금 1회 제출하고 개선을 이어간다"를 선택한 것이다.
사용자가 승인한 것은 1회 제출이다. 그 뒤에 하는 추가 제출은 다시 승인을 받는다(CLAUDE.md 규칙).
과정
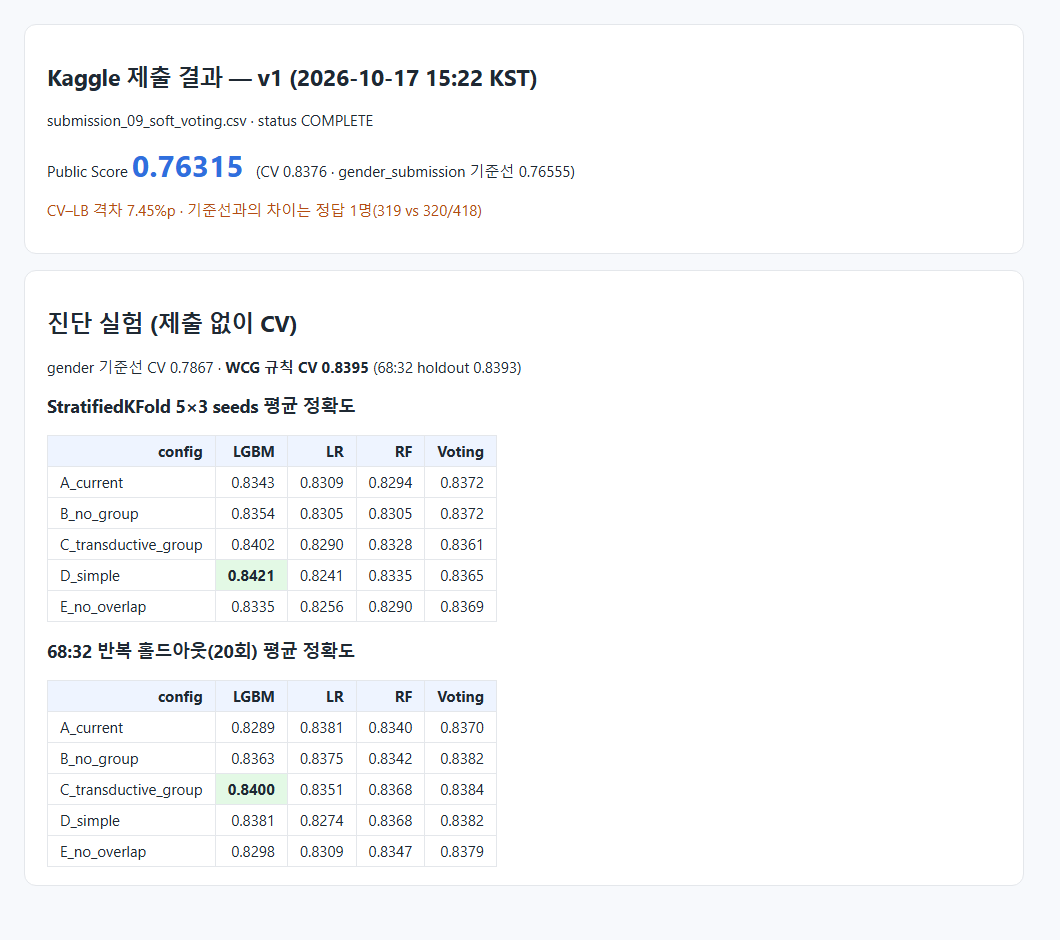
제출15:22kaggle competitions submit으로 v1(Soft Voting)을 제출했다. 토큰은 .env에서 환경변수로만 불러왔고 출력하지 않았다. 결과 Public 0.76315. 제출 성공
자문·판단15:23CV 0.8376보다 7.45%p 낮았다. 성별만 쓰는 기준선(0.76555)보다도 낮다. 격차 아주 중요한 판단이라고 보고 astra에 자문했다.
모델링·검증15:24v1과 gender_submission을 비교했다. 418명 중 39명(9.3%)의 예측이 다르다. v1은 3등석 여성의 75%를 생존으로, 남성의 3~12%를 생존으로 예측했다.
모델링·검증15:25TicketGroupSize 분포를 비교했다. 평균이 train 1.79, test 1.71(train만 기준), test 2.06(train+test 기준)이다. test의 티켓 중 36%만 train에 나온다. 분포 차이가 작아서 격차의 주원인으로 보기 어렵다.
모델링·검증15:26–15:35experiments.py로 진단 실험을 했다. 특징 구성 5개(A 현재 / B 집단 특징 제거 / C train+test 티켓 빈도 / D 단순 특징 / E 중복 특징 제거)와 모델 4개(LR, RF, LGBM, Voting)를 조합했다. StratifiedKFold 5×3 seed로 비교하고, 실제 train:test 비율인 68:32 반복 홀드아웃(20회)도 같이 봤다. 제출은 하지 않았다.
모델링·검증15:36wcg.py로 Woman-Child-Group 규칙 모델을 만들었다. 집단 생존 정보는 학습 fold의 라벨만 사용한다. CV 0.8395로, 학습한 ML 모델 없이 최고 ML 모델과 같은 수준이다. test에서 성별 규칙과 다르게 예측한 사람은 16명(남자아이→생존 8명, 여성→사망 8명)이다.
모델링·검증15:38후보 제출 파일 2개를 만들었다(제출은 하지 않음): submission_wcg.csv, submission_lgbm_simple.csv(D_simple LGBM, CV 0.8421). 두 파일은 v1과 각각 27명씩 예측이 다르다.
자문 기록
gpt-6-astra (xhigh) 요약:
원본 Titanic은 test 418명 전원을 public으로 채점한다. 0.76315와 0.76555는 정답 319명과 320명이므로 기준선과의 차이는 1명이다. 그래도 7.45%p 격차를 운으로만 설명하면 안 된다.
원인 우선순위: 구현 불일치 → 집단 특징 왜곡 → CV로 고르면서 생긴 과적합과 표본 차이.
제출 없이 할 것: 성별 기준선 CV, 집단 특징을 뺀 경우와 train+test 집계의 비교, 68:32 가상 분할.
제출이 필요한 것: 실제 test 정확도 확인뿐이다. 진단 가치가 큰 후보만 최대 2회 제출한다.
개선 후보: 단순 모델, 특징 축소, train+test 결합 집계(타깃 누수는 아니지만 규정에 명시적 허용 조항은 없음), woman-child-group 보정.
최종 판단 (Claude): 제안한 진단을 CV로 모두 수행했다. 결과는 다음과 같다.
특징 구성 A~E의 차이는 모두 노이즈 범위(0.824~0.842, 표준편차 약 0.02)였다. 특정 특징이 격차의 원인이라는 증거는 없다.
고정 규칙인 gender 기준선도 CV 0.787에서 LB 0.766으로 약 2%p 떨어진다. test 세트 자체가 조금 더 어렵다는 뜻이다.
나머지 약 5%p는 모델의 일반화 손실과 표본 변동으로 판단했다.
다음 제출 후보로 WCG 규칙을 1순위로 정했다. 학습하는 파라미터가 없어서 과적합 위험이 가장 낮기 때문이다.
결과 / 증거
v1 Public 0.76315(CV 0.8376). 성별 기준선 CV 0.7867 / LB 0.76555. 특징 구성 최고 CV는 D_simple+LGBM 0.8421, WCG 규칙 CV 0.8395.
결과 파일: titanic/reports/experiments_v2.csv. CatBoost는 네트워크 문제로 아직 설치되지 않았다(다운로드 7.6MB/100MB에서 멈춤).
20261017_153710_titanic-submit-v1-and-diagnostics.png — Kaggle v1 Public 점수와 CV 진단 실험 결과(계정 정보 미포함)
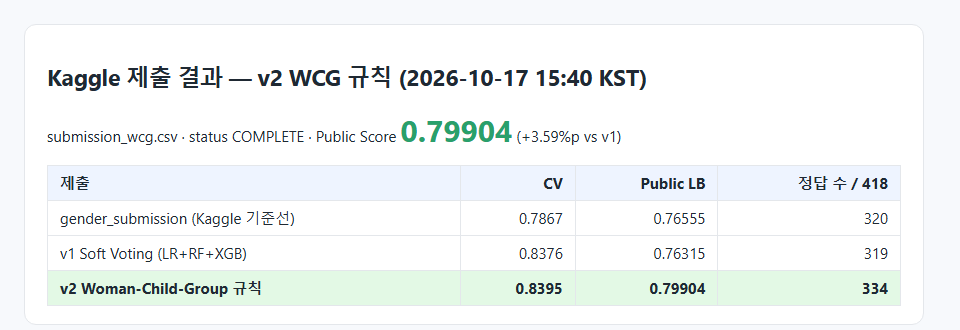
제출15:39submission_wcg.csv를 제출했다(메시지 "v2 woman-child-group rule, CV 0.8395"). 결과 Public 0.79904. 성공
자문·판단15:40Jev에게 v1 대비 향상이 노이즈가 아닌 실제 효과인지 물었다. 답은 0.53(애매함).
기록·문서화15:40증거 이미지를 만들다가 셸 이스케이프 실수로 파일명에 날짜가 들어가지 않았다. 올바른 이름으로 옮기고, 이전 시도에서 남은 중복 파일은 삭제했다.
자문 기록 / 판단
Jev (noul): "v2의 향상이 노이즈가 아닌 실제 효과인가?" → 0.53.
최종 판단 (Claude): Jev의 답이 애매해서 직접 계산했다. v2는 gender 기준선과 16명만 다르게 예측했는데 정답이 320명에서 334명으로 14명 늘었다. 즉 바꾼 16명 중 15명이 맞았다. 우연으로 보기 어려우므로 실제 효과로 판단했다. 같은 가족 집단의 생존 정보가 Titanic에서 가장 강한 신호라는 점을 확인한 셈이다.
교훈: CV 점수는 v1과 v2가 거의 같았지만(0.8376 vs 0.8395) LB에서는 3.6%p 차이가 났다. 데이터가 작으면 CV만으로는 일반화 성능을 구분하기 어렵다. 같은 성능이라면 학습할 값이 적은 단순한 규칙이 더 잘 일반화됐다.
20261017_154030_titanic-submit-v2-wcg.png — gender / v1 / v2 제출 결과 비교 (계정 정보 미포함)
2026-10-17 16:26 → 16:33 (KST)
#007 WCG + ML 결합 실험 (H1 / H2 / H3)
자문·판단모델링·검증기록·문서화
지시 (원문)
WCG와 ML 결합으로 진행해.
분석
WCG 규칙(LB 0.79904)을 기본으로 두고, 규칙이 다루지 못하는 사람에게 ML을 써서 더 맞힐 수 있는지 확인한다.
결합 방식 후보 세 가지를 같은 fold에서 비교한다.
H1: WCG 집단 정보가 있는 여성·남자아이는 WCG로, 나머지는 ML로 예측한다.
H2: WCG에 ML 확률 임계값으로 보정을 더한다.
H3: WCG 집단 생존율을 ML 특징으로 넣는다.
이번 지시는 실험까지다. 추가 제출은 따로 승인을 받는다.
과정
자문·판단16:26astra(xhigh)에게 결합 설계를 물었다(백그라운드).
모델링·검증16:27features.py에 extra 옵션을 추가했다. cross-fitting으로 만든 WCG 특징을 ML 입력에 그대로 붙일 수 있게 하기 위해서다.
모델링·검증16:27hybrid.py를 작성했다. 모든 라벨 의존 통계(WCG 집단 생존율, H2 임계값, 모델)는 외부 학습 fold로만 학습한다. H2 임계값은 학습 fold 안에서 다시 3-fold로 나눠 고르고(중첩 CV), H3 특징은 학습 fold 안의 OOF로 만든다. 기본 ML은 LR(A 특징), LGBM(D 단순 특징), Voting(A 특징) 세 가지다.
모델링·검증16:27–16:29StratifiedKFold 5×3 seed로 실행했다. 성공
모델링·검증16:30astra의 권고대로 seed별로 개선 방향이 같은지와 WCG 대비 변경분의 정확도를 계산했다. H1 제출 파일 2개를 만들었다(제출은 하지 않음).
기록·문서화16:31증거 이미지를 저장하다가 같은 셸 이스케이프 실수(\$)가 다시 나와 파일 이름을 바로잡았다. 재발하지 않도록 CLAUDE.md에 경로 작성 규칙을 추가했다.
자문 기록
gpt-6-astra (xhigh) 요약:
H1은 단순하지만, WCG 정보가 없는 사람에게 ML이 성별 규칙보다 나은지 따로 검증해야 한다.
H2는 세그먼트와 임계값을 반복해서 고르면 과적합된다.
H3는 바깥 fold마다 OOF 특징을 다시 만들어야 한다.
임계값은 중첩 CV로 고르고, 성능이 비슷하면 변경이 적은 쪽을 택한다.
지표는 WCG와 다르게 예측한 수 m과 그 변경분의 정확도 C/m(50%를 넘어야 순이득)을 쓰고, 반복마다 개선 방향이 같은지도 본다.
후보는 최대 2개로 좁히고, 개선이 불확실하면 WCG를 유지하는 것이 합리적이다.
Jev (choice): 다음에 무엇을 제출할까 → WCG 유지(0.60), H1_Voting(0.21), H1_LGBM(0.19). 근거로 "이전에도 ML의 CV 이득이 LB로 이어지지 않았다"는 점을 들었다.
Claude 판단: 제출할 후보를 하나 고른다면 H1_Voting_A다. 변경분 정확도가 가장 높고(0.587), fold 11승 1무 3패에 seed 3개 모두에서 개선됐으며, test 변경이 22명으로 더 적다. 기대 이득은 22×(0.587−0.413) ≈ +4명(+0.9%p) 정도로 작고 불확실하다. 그래서 제출할지는 사용자가 정하도록 묻기로 했다.
결과 / 증거
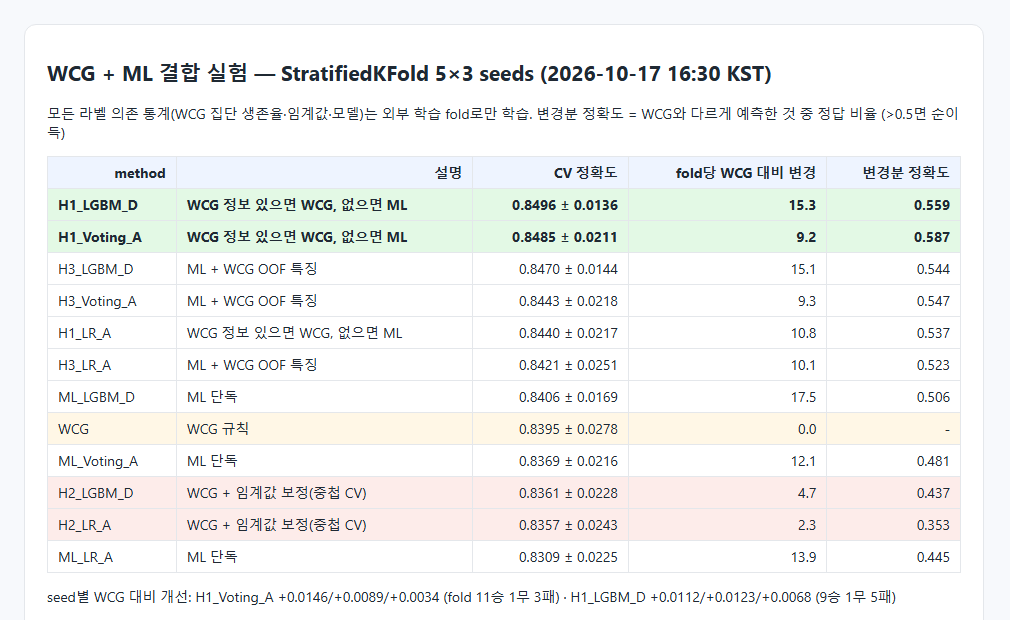
H1이 가장 좋았다: LGBM_D 0.8496, Voting_A 0.8485로 WCG 0.8395보다 약 1%p 높다. 변경분 정확도는 0.56~0.59로 50%를 넘는다.
H2는 WCG보다 나빴다: 0.836, 변경분 정확도 0.35~0.44. 고른 임계값도 fold마다 크게 달랐다. 작은 데이터에서 임계값을 튜닝하면 과적합된다는 것을 확인했다.
H3는 0.842~0.847로 H1보다 조금 낮았다. ML 단독은 0.831~0.841이었다.
test 적용: WCG 집단 정보가 있는 사람은 418명 중 56명이다. H1_Voting은 WCG 대비 22명을 바꾼다(3등석 여성→사망 12, 1등석 남성→생존 5, 3등석 남성→생존 5). H1_LGBM은 33명을 바꾼다.
결과 파일: reports/hybrid_summary.csv, reports/hybrid_folds.csv, submissions/submission_h1_*.csv, submissions/submission_h2_*.csv
20261017_163100_titanic-wcg-ml-hybrid-cv.png — 결합 방식별 CV 정확도와 변경분 정확도
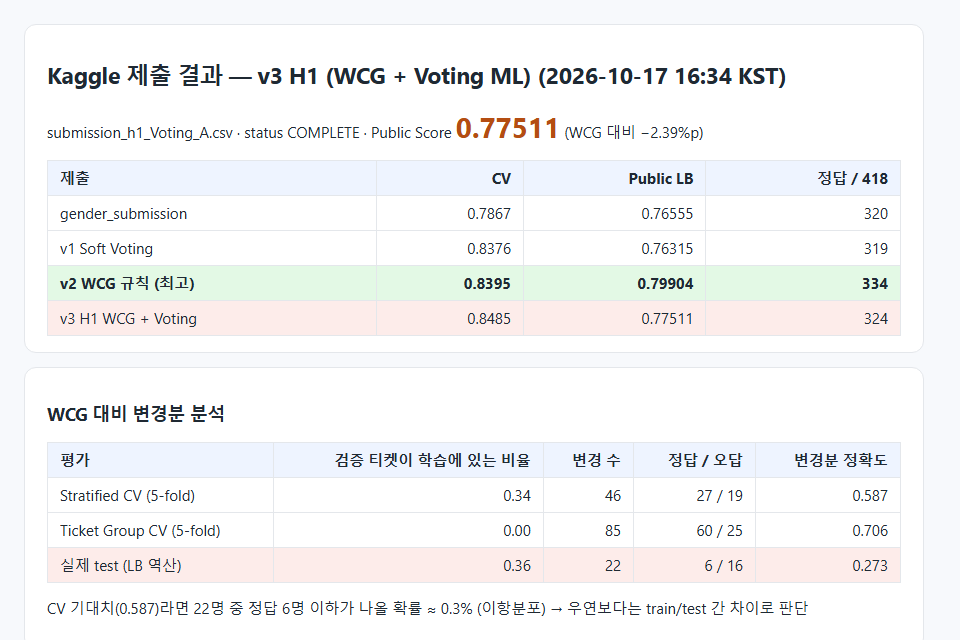
모델링·검증16:35가설을 검증했다. 가설은 "일반 CV에서는 같은 티켓 일행이 학습 fold에 있어서 ML이 유리하게 평가됐다"였다. 하지만 검증 승객의 티켓이 학습에 있는 비율은 일반 CV 0.34로 실제 test 0.36과 비슷했다. 티켓 그룹 CV(0.00)에서는 오히려 H1의 이득이 더 컸다(변경분 정확도 0.706). 가설은 기각했다.
모델링·검증16:36CV 기대치 0.587이 맞다면 22명 중 정답이 6명 이하일 확률은 이항분포로 0.29%다. 우연이라기보다는, 규칙이 다루지 못하는 집단(3등석 여성, 성인 남성)에서 train과 test의 생존 패턴이 다르다고 판단했다. 그 차이의 구체적인 원인은 밝혀내지 못했다.
자문 / 판단
#007에서 Jev는 "WCG 유지"(0.60)를 골랐고, 그 근거는 "ML의 CV 이득이 LB로 이어지지 않는다"였다. 결과적으로 Jev의 판단이 맞았다. Claude는 H1을 추천했지만 이 추천은 틀렸다.
최종 판단 (Claude): 최종 모델은 v2 WCG 규칙(0.79904)으로 유지한다. Titanic에서 ML의 CV 이득은 두 번(v1, v3) 모두 LB로 이어지지 않았다. CV만 보고 추가 제출을 계속하면 LB를 보고 고르는 과적합이 되므로, 추가 제출은 하지 않는 것을 권장한다.
교훈: 작은 데이터에서는 CV 이득이 리더보드 이득을 보장하지 않는다. 변경 규모가 작으면(22명) 그 변경분의 정확도를 CV로 추정한 값의 불확실성이 매우 크다.
20261017_163557_titanic-submit-v3-h1.png — 제출 이력과 WCG 대비 변경분 분석 (계정 정보 미포함)
PHASE 5
정리와 공유
목적노트북, 웹 리포트로 정리하고 기록을 단계와 목적별로 재구성한다.
결과실행된 노트북, 웹 리포트 게시, history 재구성
2026-10-17 16:37 → 16:48 (KST)
#009 공유용 노트북 · 웹 HTML 리포트 · history 재구성
자문·판단기록·문서화설정·환경
지시 (원문)
공유용 노트북으로 정리해줘. 그리고 web으로 볼 수 있도록 html 레포트로 작성해줘. history.html 또한 단계 및 목적별로 세분화.
분석
요구는 세 가지다.
실행 결과가 들어 있는 공유용 노트북
웹에서 볼 수 있는 HTML 리포트
history.html을 단계(Phase)와 목적별로 나누기
리포트는 외부 리소스 없이 그림을 내장한 단일 HTML로 만들고, 비공개 웹 페이지(Artifact)로 게시해서 링크로 볼 수 있게 한다.
history는 프로젝트 규칙인 시간순을 유지한다. 그 위에 단계 묶음과 목적 태그를 더한다.
과정
자문·판단16:37Jev에게 history 재구성 방식을 물었다(아래 자문).
기록·문서화16:38titanic/notebooks/build_notebook.py로 노트북 titanic_analysis.ipynb를 만들었다. 구성은 데이터·EDA → 특징·검증 → 모델 비교 → 첫 제출과 진단 → WCG → 결합 → 결론의 7개 장이다. 오래 걸리는 계산은 저장된 결과를 불러오고, 빠른 부분(LR, LGBM, WCG의 CV)은 노트북 안에서 다시 실행한다.
설정·환경16:381시간 넘게 재시도하던 CatBoost 설치가 끝났다. 지금까지의 실험에는 CatBoost가 포함되지 않았다.
기록·문서화16:40titanic/reports/build_report.py로 웹 리포트를 만들었다. 그림은 base64로 내장했고, 점수 비교 차트는 SVG(0.70~0.88 한 스케일)로 그렸다. 밝은 테마와 어두운 테마를 모두 지원한다. test에서 WCG가 예측을 뒤집은 실제 사례 2건도 넣었다.
설정·환경16:41노트북 실행이 실패했다. 기본 커널이 전역 Python이라 sklearn이 없었다. 문제 venv 전용 커널(--sys-prefix)을 등록했지만, python -m jupyter가 전역 nbconvert를 불러서 다시 실패했다. python -m nbconvert로 직접 실행하자 코드 셀 12개가 모두 오류 없이 실행됐다. 성공 노트북 HTML 내보내기(titanic_analysis.html)도 함께 만들었다.
기록·문서화16:43공유하기 전에 노트북과 리포트의 민감정보를 검사했다. .env 값, 토큰·IP 패턴, 로컬 경로와 사용자명이 모두 없었다. OK
기록·문서화16:44리포트를 비공개 웹 페이지로 게시했다: Titanic 생존 예측 분석. 다른 사람이 보려면 페이지의 Share 메뉴에서 공유해야 한다.
기록·문서화16:45리포트를 밝은 테마로 렌더링한 스크린샷을 증거로 저장했다.
기록·문서화16:46history.html을 재구성했다. 단계 6개(Phase 0~5)마다 목적과 결과를 적고, 작업 단계마다 목적 태그를 붙였다. 목적별 필터, 단계 목차, LB 점수판도 추가했다. 기존 내용은 그대로 두었고, 재구성 전 파일은 임시 폴더에 백업했다.
자문 기록
Jev (choice): history를 어떻게 재구성할까 → 단계 묶음 + 목적 태그 + 필터(1.00). 목적별로만 묶는 안과 단계별로 페이지를 나누는 안은 0.00.
최종 판단 (Claude): Jev의 안대로 했다. 목적 태그는 기록·문서화, 설정·환경, 리서치, 자문·판단, 데이터, EDA, 모델링·검증, 제출의 8가지다. 키워드로 자동 분류해 보니 오분류가 많아서 단계마다 직접 지정했다.
노트북에서 다시 실행한 LR CV(0.8372)는 원래 결과(0.8309)와 다르다. 노트북은 seed 1개, 원래 결과는 seed 3개 평균이라서 생긴 차이이고, 노트북에도 이 점을 적었다.
웹 리포트: titanic/reports/titanic_report.html(게시용), titanic_report_standalone.html(로컬 브라우저용). 게시 링크는 위 과정 7번에 있다.
history.html: 단계 0~5, 목적 태그와 필터, 단계 목차
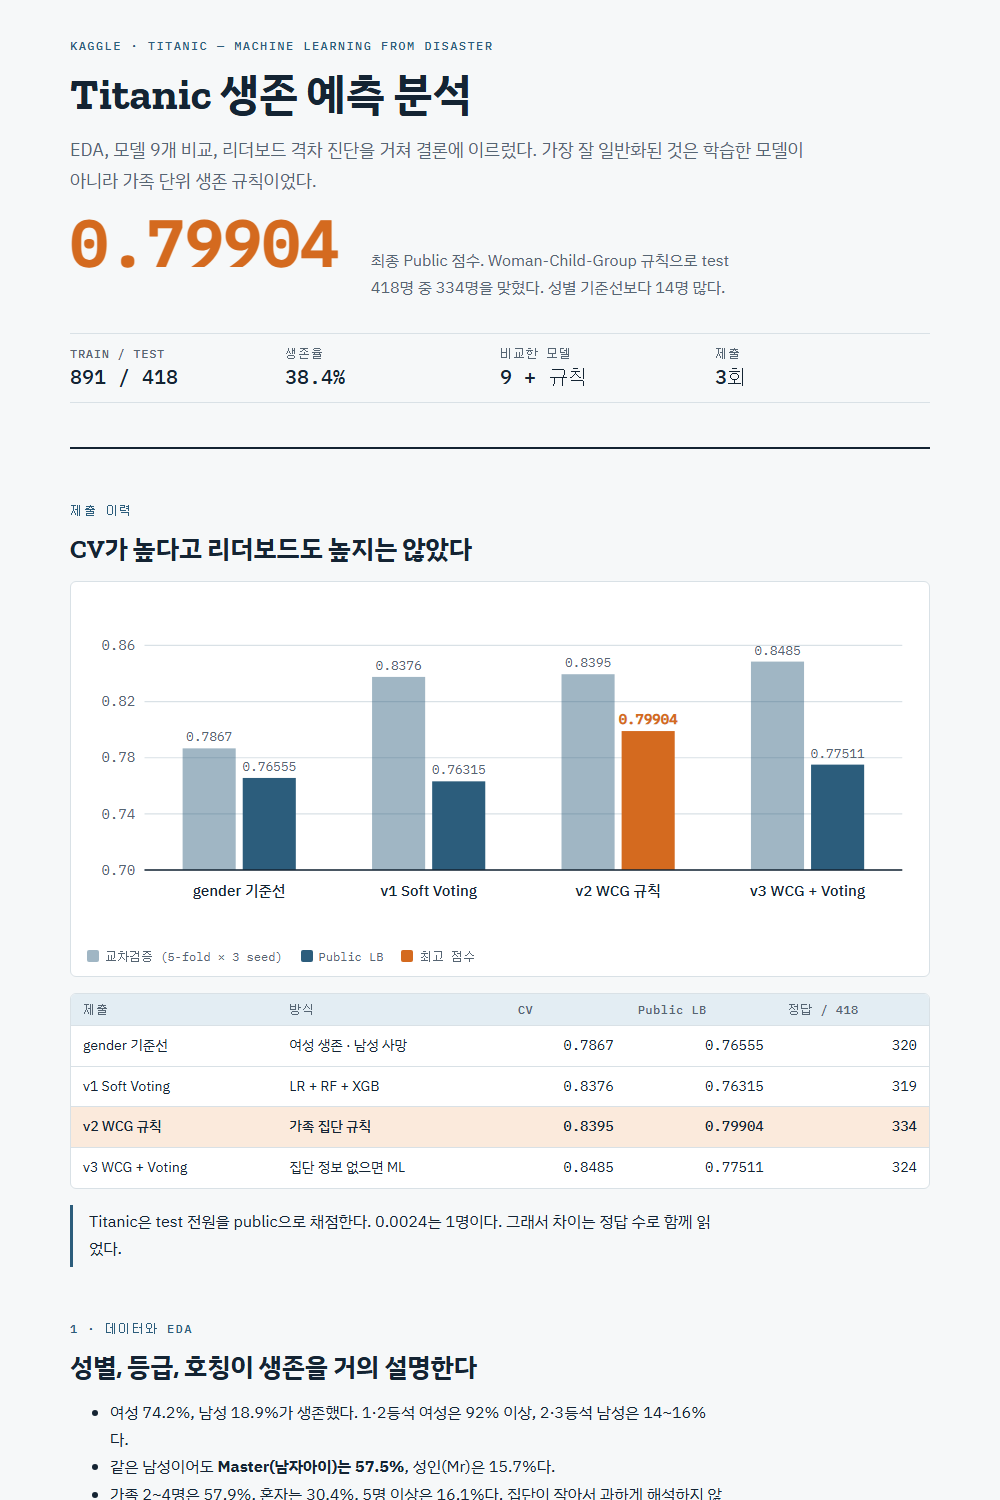
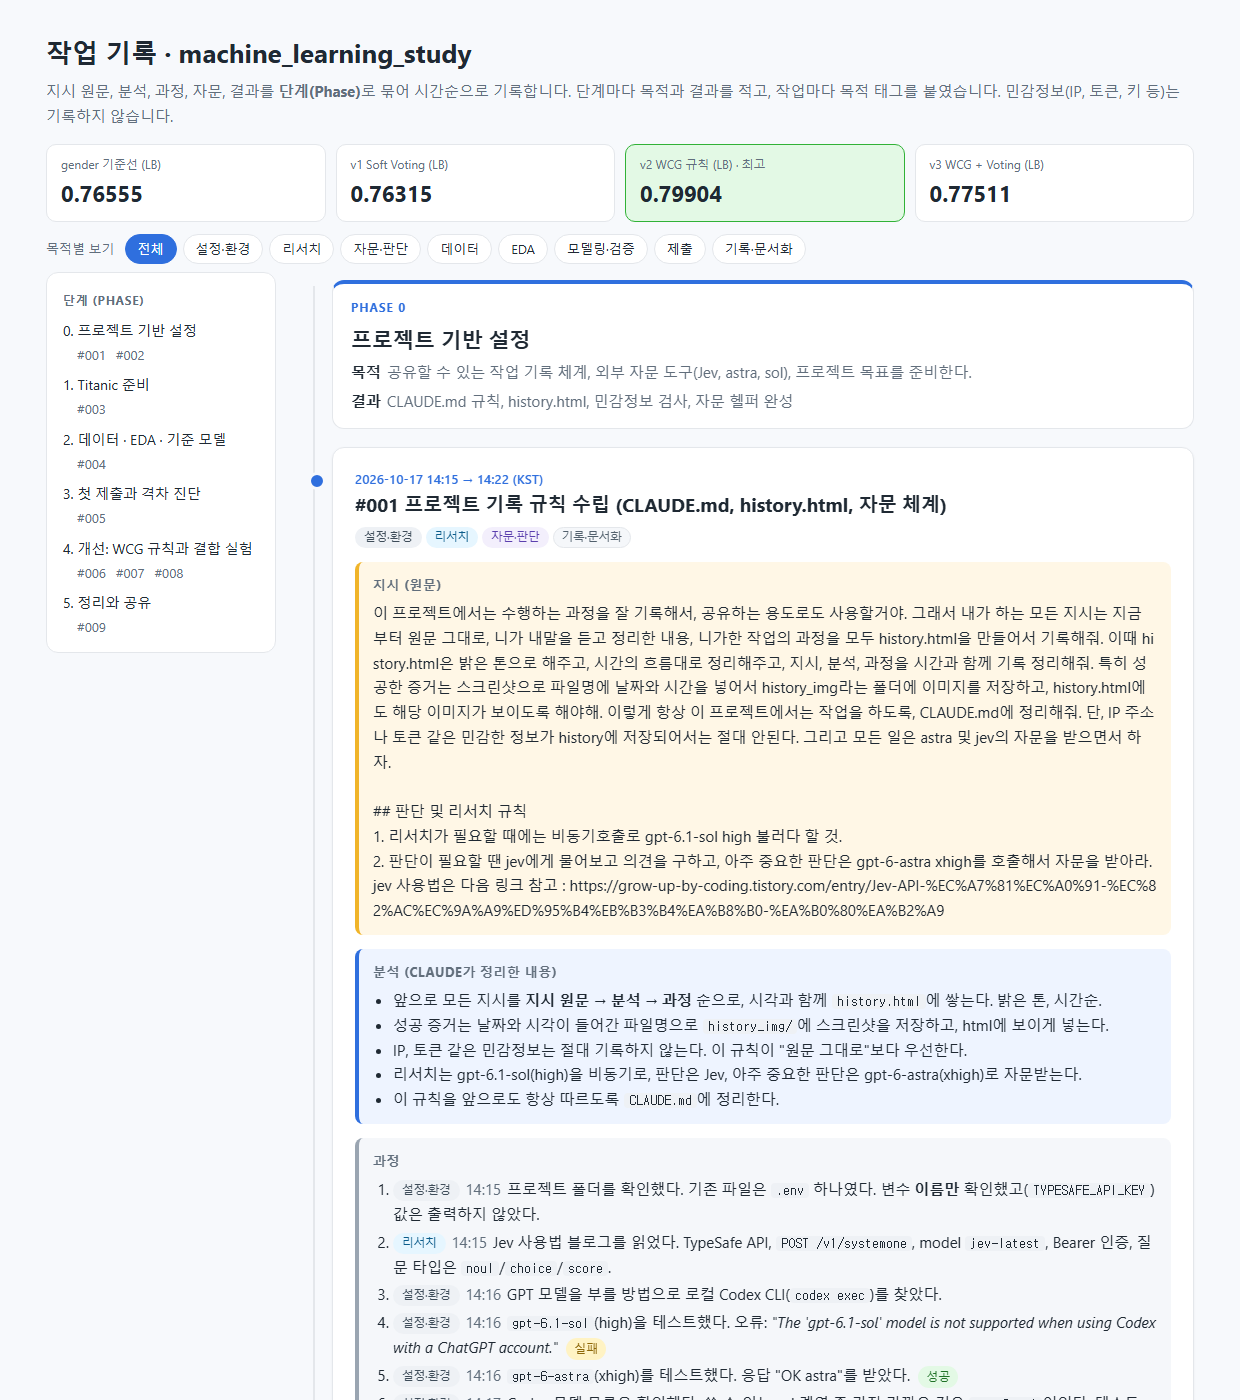
20261017_164529_titanic-web-report.png — 웹 리포트 상단 (최종 점수, 제출 이력 차트)20261017_164741_history-restructured.png — 재구성된 history (LB 점수판, 목적별 필터, 단계 목차, 단계별 목적·결과)
PHASE 6
Spaceship Titanic 준비
목적두 번째 대회(Spaceship Titanic)의 데이터, 검증 설계, 성공 기준을 Titanic의 교훈을 반영해 준비한다.
결과폴더 구성, 리서치·자문 요청, 대회 규칙 동의 확인
2026-10-17 16:54 → 16:55 (KST)
#010 Spaceship Titanic 시작
설정·환경리서치자문·판단데이터
지시 (원문)
https://www.kaggle.com/competitions/spaceship-titanic 다음 데이터셋 진행
분석
Titanic 다음 과제로 Kaggle Spaceship Titanic을 진행한다. 승객이 다른 차원으로 이동했는지(Transported)를 맞히는 이진분류이고, 평가는 accuracy다.
Titanic과 같은 방식으로 spaceship/ 폴더를 구성한다. Titanic의 교훈(작은 차이에 대한 CV의 한계, 제출 최소화, 단순한 규칙의 가치)을 반영해 검증과 제출 기준을 먼저 정한다.
과정
설정·환경16:54spaceship/{data/raw, data/processed, notebooks, src, reports/figures, submissions} 폴더를 만들었다.
데이터16:54tools/kaggle_download.py로 다운로드를 시도했다. 결과는 HTTP 403, 대회 규칙에 아직 동의하지 않은 상태다. 대기 사용자에게 Join Competition을 요청했다.
리서치16:54sol(high, 웹 검색)에게 대회 정보, 상위 노트북의 특징 공학, CV/LB 점수대, 주의점 조사를 비동기로 요청했다.
자문·판단16:54astra(xhigh)에게 Titanic 교훈을 적용하는 방법, 그룹 누수, 결측 대치, 제출 전략, 성공 기준을 물었다(백그라운드).
결과 / 남은 일
대회 규칙 동의를 기다리는 동안 리서치와 자문을 백그라운드로 실행했다. 사용자가 규칙에 동의한 뒤의 진행은 #011에 있다.
PHASE 7
Spaceship 데이터 · EDA · 기준 모델
목적데이터를 받아 대치 규칙을 EDA로 검증하고, 그룹 단위 CV로 모델을 비교해서 첫 제출 기준선을 정한다.
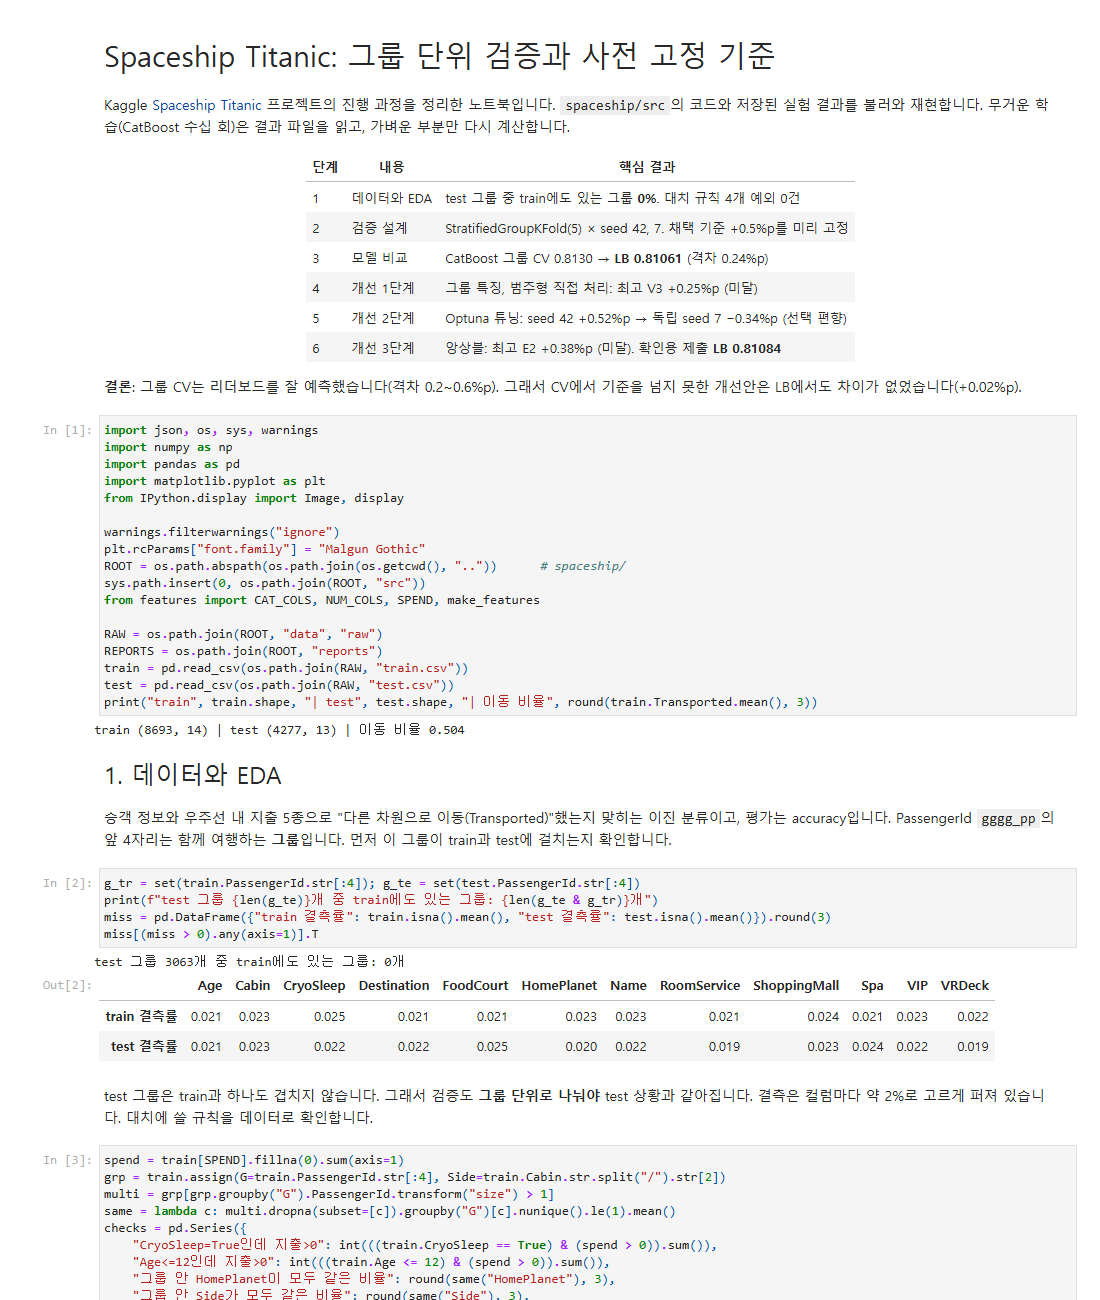
결과대치 규칙 4개를 train 예외 0건으로 확인. CatBoost 그룹 CV 0.8130 → 기준선 Public 0.81061 (CV−LB 0.24%p)
2026-10-17 16:55 → 17:08 (KST)
#011 Spaceship 데이터 다운로드 · EDA · 모델 비교
데이터EDA모델링·검증자문·판단리서치기록·문서화
지시 (원문)
완료
분석
사용자가 대회 규칙에 동의했다. 할 일: 데이터 다운로드 → EDA → 검증 설계 → 모델 비교. 제출은 승인을 받은 뒤에 한다.
과정
데이터16:55다운로드에 성공했다. train 8,693행 14열, test 4,277행, 타깃 비율 0.504. test의 그룹(PassengerId 앞 4자리) 중 train에도 있는 그룹은 0%다. 성공
자문·판단16:55astra의 자문을 받았다(아래). 그룹이 train과 test에 걸치지 않으므로 StratifiedGroupKFold(그룹 단위)를 주검증으로 정했다. 성공 기준도 미리 고정했다.
EDA16:57spaceship/src/eda.py로 대치 규칙을 검증했다. 결과는 아래 EDA 핵심에 있다. 성공
모델링·검증16:57spaceship/src/features.py를 작성했다. 타깃을 쓰지 않는 결정적 규칙만으로 대치하고, 그룹 크기, Cabin 분해(Deck/번호/Side), 지출 로그와 합계, 무지출 여부, 나이 구간, 성(Surname) 인원 수를 만들었다. 남은 결측은 Pipeline 안의 학습 fold에서 대치한다.
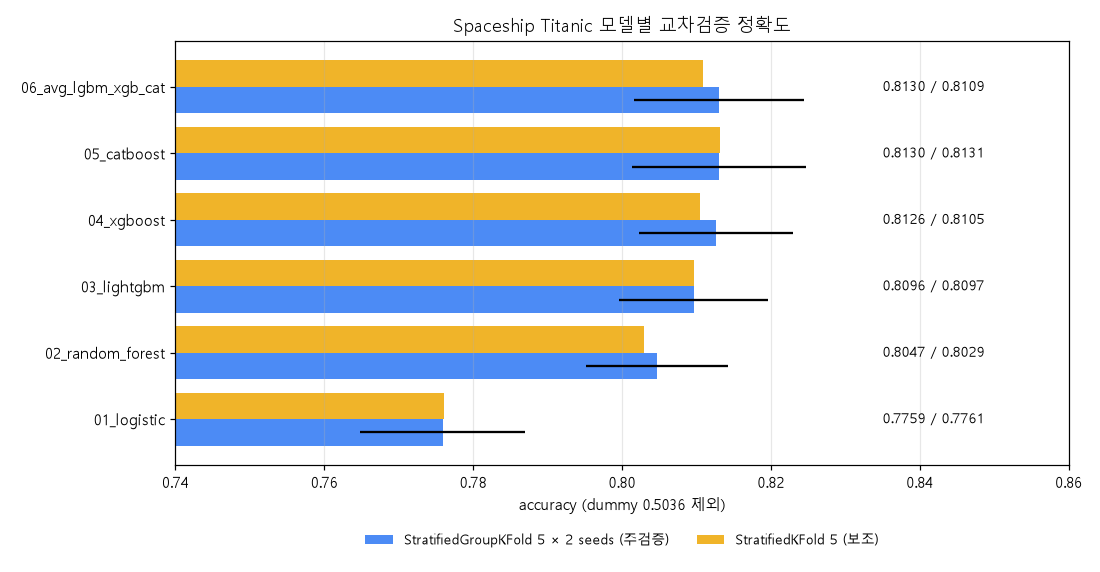
모델링·검증16:57–17:05spaceship/src/train.py로 모델 7개를 비교했다. 그룹 CV 5-fold × seed 2개를 주검증으로, 일반 Stratified CV를 보조로 썼다. 상위 2개 모델의 제출 파일을 만들었다(제출은 하지 않음). 성공
리서치17:00sol 리서치 결과를 받았다(아래).
기록·문서화17:06EDA 그림에서 결측(NaN) 범주의 라벨이 축 밖에 찍히는 문제가 있어 그림에서는 결측 범주를 뺐다(표에는 남김). CV 그래프는 범례가 막대를 가려서 아래로 옮겼다. 증거 이미지를 저장했다.
EDA 핵심 (대치 규칙 근거)
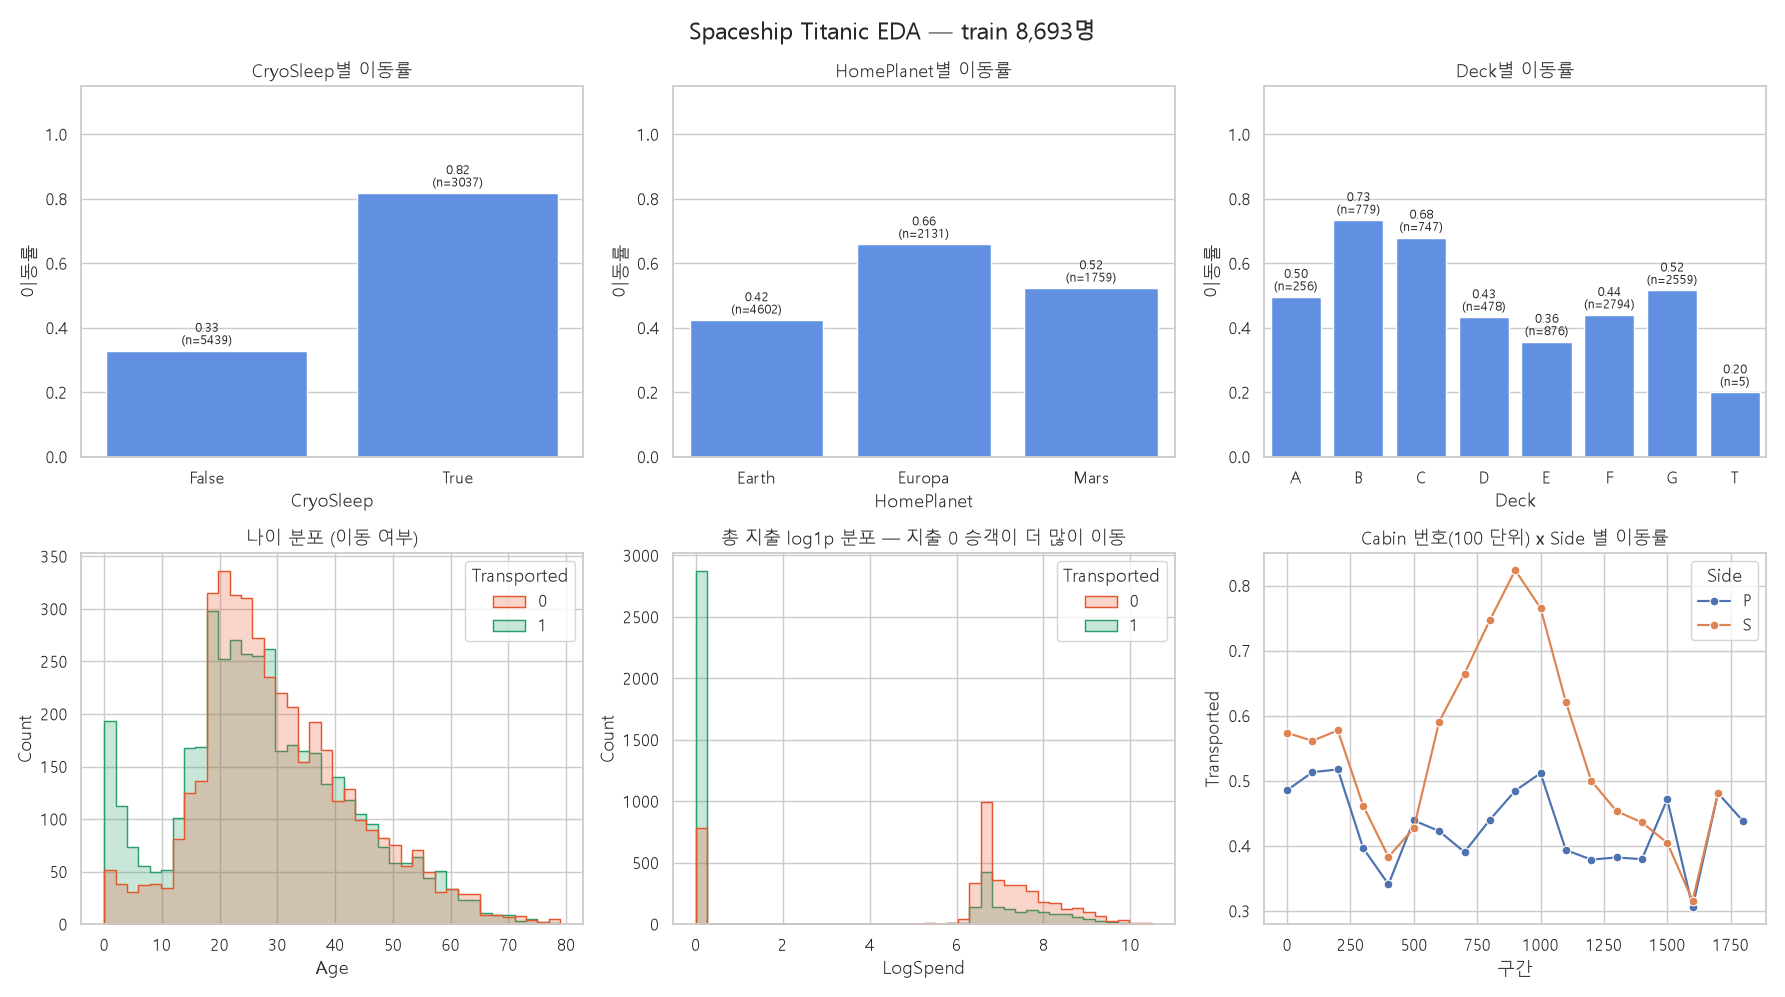
CryoSleep=True인데 지출이 있는 승객: 0 / 3,037. Age 12세 이하인데 지출이 있는 승객: 0 / 806. 따라서 두 경우의 결측 지출은 0으로 채운다.
2명 이상 그룹에서 HomePlanet과 Side가 그룹 안에서 모두 같은 비율: 100%. 따라서 그룹 최빈값으로 대치한다.
Deck A/B/C/T의 승객은 모두 Europa, Deck G는 모두 Earth다(교차표 예외 0).
반대로 지출이 0인 승객 중 CryoSleep=True는 85.4%뿐이다. "지출 0이면 수면 중"이라고 단정하지 않았다(astra와 sol의 의견도 같음).
이동률: CryoSleep 81.8% vs 32.9%, 지출 없음 78.6% vs 29.9%, Europa 65.9%, Deck B 73.4%, Side S 55.5% vs P 45.1%. Cabin 번호 구간에 따라 이동률이 크게 달라진다(S쪽 900번대 약 82%).
모델은 CatBoost → LightGBM → XGBoost → 확률 평균 순으로 본다. 제출은 총 3~5회로 제한하고, 최종 선택은 반복 CV로 한다.
성공 기준: 기준선을 고정한 뒤 개선은 반복 CV 평균 +0.5%p 이상이고 두 seed 모두에서 개선될 때만 채택한다. 누수가 없고, 재현 가능하며, 제출은 5회 이하여야 한다. CV–LB 차이가 2%p를 넘으면 원인을 점검한다.
gpt-6-sol (리서치) 요약:
리더보드는 test 전체로 계산한다.
공개 사례의 CV와 LB는 대략 0.79~0.82다. 0.89 이상의 최상위 기록은 재현성이 확인되지 않는다.
앙상블 CV가 0.8115에서 0.8126으로 올랐는데 LB는 0.8043에서 0.8013으로 떨어진 사례가 있다.
공개 사례에서는 확률 평균 앙상블이 단일 LightGBM을 넘지 못한 경우도 있었다.
최종 판단 (Claude): 첫 제출 기준선 후보는 CatBoost 단일 모델(그룹 CV 0.8130)이다. 평균 앙상블은 CV가 같으면서 더 복잡하므로 기준선으로 쓰지 않는다. 이후 개선안은 0.8180 이상(+0.5%p)이고 두 seed 모두에서 개선될 때만 채택한다.
결과 / 증거 — 그룹 CV (StratifiedGroupKFold 5 × seed 42, 7)
CatBoost 0.8130 ± 0.0117(seed42 0.8119, seed7 0.8141). 평균 앙상블 0.8130, XGBoost 0.8126, LightGBM 0.8096, RF 0.8047, LR 0.7759. 다수 클래스 기준은 0.5036이고, "지출 0이면 이동" 규칙은 0.7371이다.
그룹 CV와 일반 CV의 차이는 0.002 이내다. 그룹 정보 때문에 점수가 부풀려지는 효과는 작다.
fold 표준편차 약 0.01은 Titanic(약 0.02)의 절반이다. 상위 4개 모델의 차이(0.0034 이내)는 여전히 표준편차보다 작다.
최종 판단 (Claude): CV − LB = +0.24%p로 fold 표준편차(1.17%p) 안에 있다. Titanic(+7.45%p)과 달리 그룹 CV가 리더보드를 잘 예측한다. 그래서 다음 개선은 사전 기준(그룹 CV +0.5%p, 두 seed 모두 개선)으로 고르고, 제출은 채택한 안을 확인할 때만 한다.
결과 / 증거
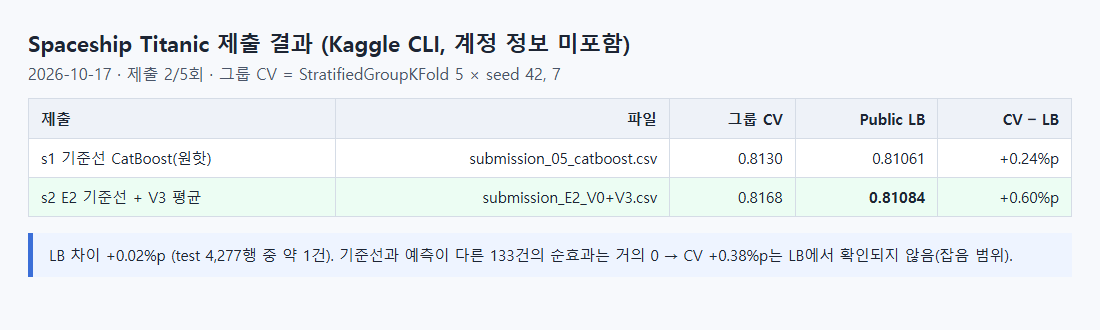
Spaceship 기준선: 그룹 CV 0.8130 → Public 0.81061. 제출 1/5회, 오늘 남은 제출 9회.
sol이 조사한 공개 사례 범위(0.79~0.82)의 윗부분에 해당한다.
20261017_170816_spaceship-submit-s1-baseline.png — 기준선 제출 결과와 CV 비교 (계정 정보 미포함)
PHASE 8
Spaceship 개선 실험
목적사전에 고정한 기준(그룹 CV +0.5%p, 두 seed 모두 개선)으로 특징과 모델 개선안을 검증하고, 기준을 넘는 것만 제출한다.
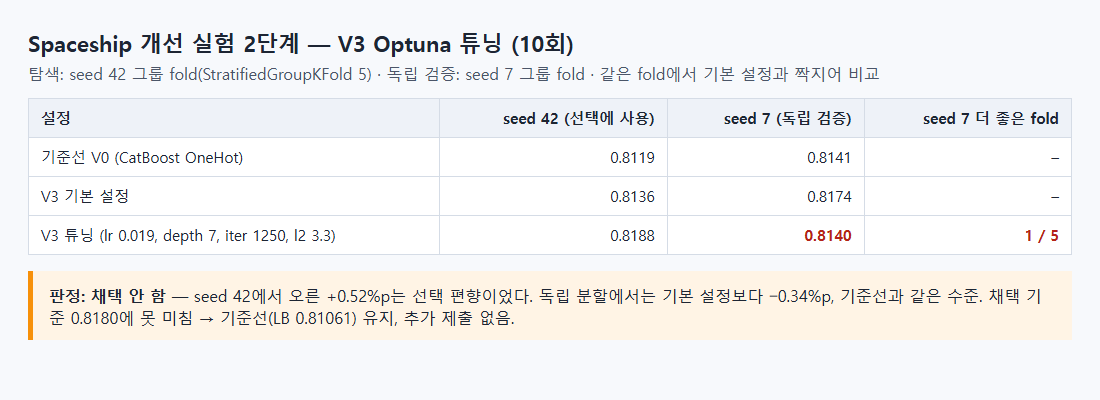
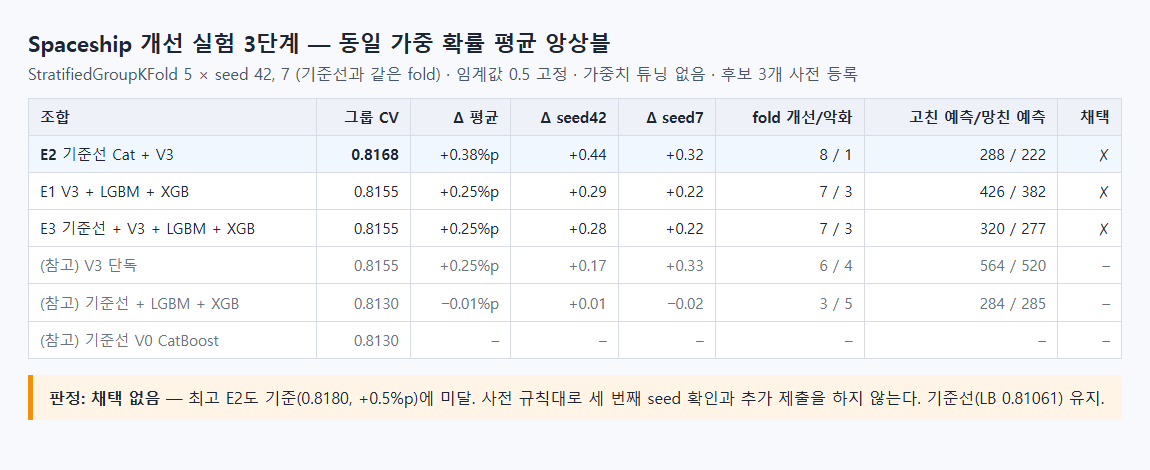
결과1단계: 기준을 넘은 안 없음(최고 V3 +0.25%p). 2단계: 튜닝도 독립 검증(seed 7)에서 기준 미달. 3단계: 앙상블 최고 E2 +0.38%p로 기준 미달. 사용자 지시로 E2를 제출 → Public 0.81084(기준선 대비 +0.02%p, 잡음 범위)
2026-10-17 17:09 → 19:01 (KST)
#013 개선 실험 1단계 (그룹 특징 · 범주형 직접 처리) → 2단계 튜닝 → 채택 없음
모델링·검증자문·판단기록·문서화
지시 (원문)
진행해
분석
앞서 제시한 개선 후보 세 가지를 같은 그룹 CV로 비교하고, 기준을 넘는 것만 2번째 제출 후보로 올리라는 승인이다.
그룹 단위 특징
CatBoost 범주형 직접 처리와 Cabin 조합
소규모 튜닝
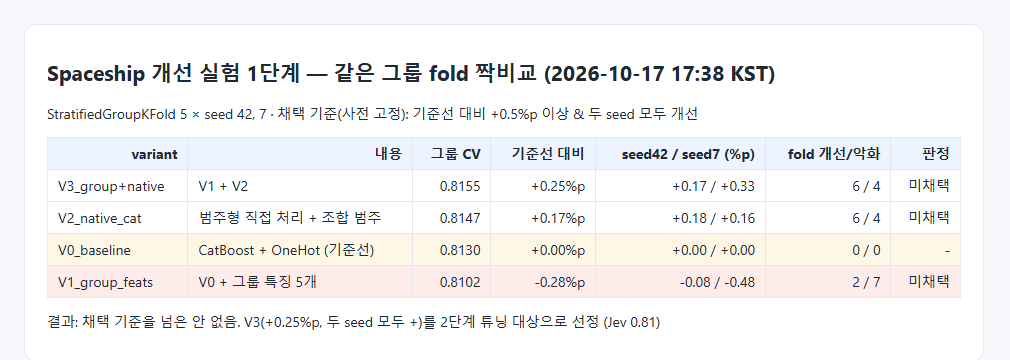
기준: 기준선(그룹 CV 0.8130) 대비 +0.5%p 이상이고 seed 42, 7 모두에서 개선. 같은 fold에서 짝지어 비교한다.
과정
모델링·검증17:09spaceship/src/improve.py를 작성했다. 비교안은 네 가지다.
V0: 기준선
V1: 그룹 특징 5개(그룹 지출 합계, 그룹 CryoSleep 비율, 그룹 무지출 비율, 아이 동반, 그룹 평균 나이)
V2: CatBoost 범주형 직접 처리와 Deck_Side, Side_CabinRegion 조합 범주
V3: V1 + V2
그룹 특징은 타깃을 쓰지 않고, 같은 집합 안의 그룹원만 본다.
모델링·검증17:10실행하는 동안 2단계 스크립트 tune.py를 준비했다. 탐색은 seed 42 fold에서만 하고, 고른 파라미터는 seed 7 fold에서 독립 검증해서 선택 편향을 막는다.
모델링·검증17:10–17:381단계 실험을 마쳤다(약 28분, CatBoost 40회 학습). 채택 없음 결과는 아래에 있다.
20261017_232913_spaceship-submit-s2-e2.png — 두 제출의 CV와 LB 비교 (계정 정보 미포함)
PHASE 9
Spaceship 정리와 공유
목적Spaceship Titanic의 과정과 결론을 Titanic처럼 공유용 노트북과 웹 리포트로 정리한다.
결과노트북 22셀 실행 오류 0, HTML 내보내기, 웹 리포트 게시(비공개)
2026-10-17 23:24 → 23:38 (KST)
#017 Spaceship 공유용 노트북과 웹 리포트
기록·문서화
지시 (원문)
1번도 진행해줘.
분석
E2 제출 도중에 받은 지시다. 앞서 제시한 1번 "Spaceship 정리: Titanic처럼 공유용 노트북과 웹 리포트로 만들기"를 제출과 함께 진행하라는 뜻이다.
Titanic과 같은 구조로 만든다. 노트북은 저장된 결과를 읽고 가벼운 부분만 다시 계산하며, 리포트는 Artifact로 게시한다. 공유 전에 로컬 경로, 사용자명, 토큰이 없는지 검사한다.
과정
기록·문서화23:30spaceship/notebooks/build_notebook.py를 작성했다. 데이터, EDA 규칙 확인, 특징, 모델 비교(LightGBM 그룹 CV 재현), 개선 1~3단계, 제출 비교, 교훈 순서이고 셀은 22개다.
기록·문서화23:31venv 커널로 실행했다. 오류는 0이었다. 다만 "지출 0 승객 중 CryoSleep=True 비율"이 EDA(0.854)와 달리 0.831로 나왔다. 결측 CryoSleep을 분모에 넣었기 때문이어서 EDA와 같은 정의로 고치고 다시 실행했다(0.854). HTML로도 내보냈다. 성공
기록·문서화23:33spaceship/reports/build_report.py를 작성했다. 제출 CV–LB 막대, EDA 규칙 카드, 모델 표, 개선안 전체를 채택선(+0.5%p)과 함께 보는 가로 막대를 넣었다.
기록·문서화23:34렌더링을 확인하다가 두 가지를 고쳤다. 튜닝 막대가 선택에 쓴 seed 42 점수까지 평균해서 +0.34%p로 부풀려 보였다. 그래서 막대는 독립 검증 seed 7만 쓰고, seed 42는 점으로만 보이게 바꿨다. 또 값 라벨이 seed 점과 겹쳐서 라벨을 점 오른쪽으로 옮겼다.
기록·문서화23:35노트북, HTML, 리포트에서 사용자명, 로컬 경로, 이메일, 키 이름을 검사했다(0건). 리포트를 비공개 Artifact로 게시했다. 성공
기록·문서화23:37증거 이미지를 저장하고 CLAUDE.md에 생성 명령과 리포트 위치를 적었다.
결과 / 증거
노트북: spaceship/notebooks/spaceship_analysis.ipynb(22셀, 실행 오류 0), spaceship_analysis.html
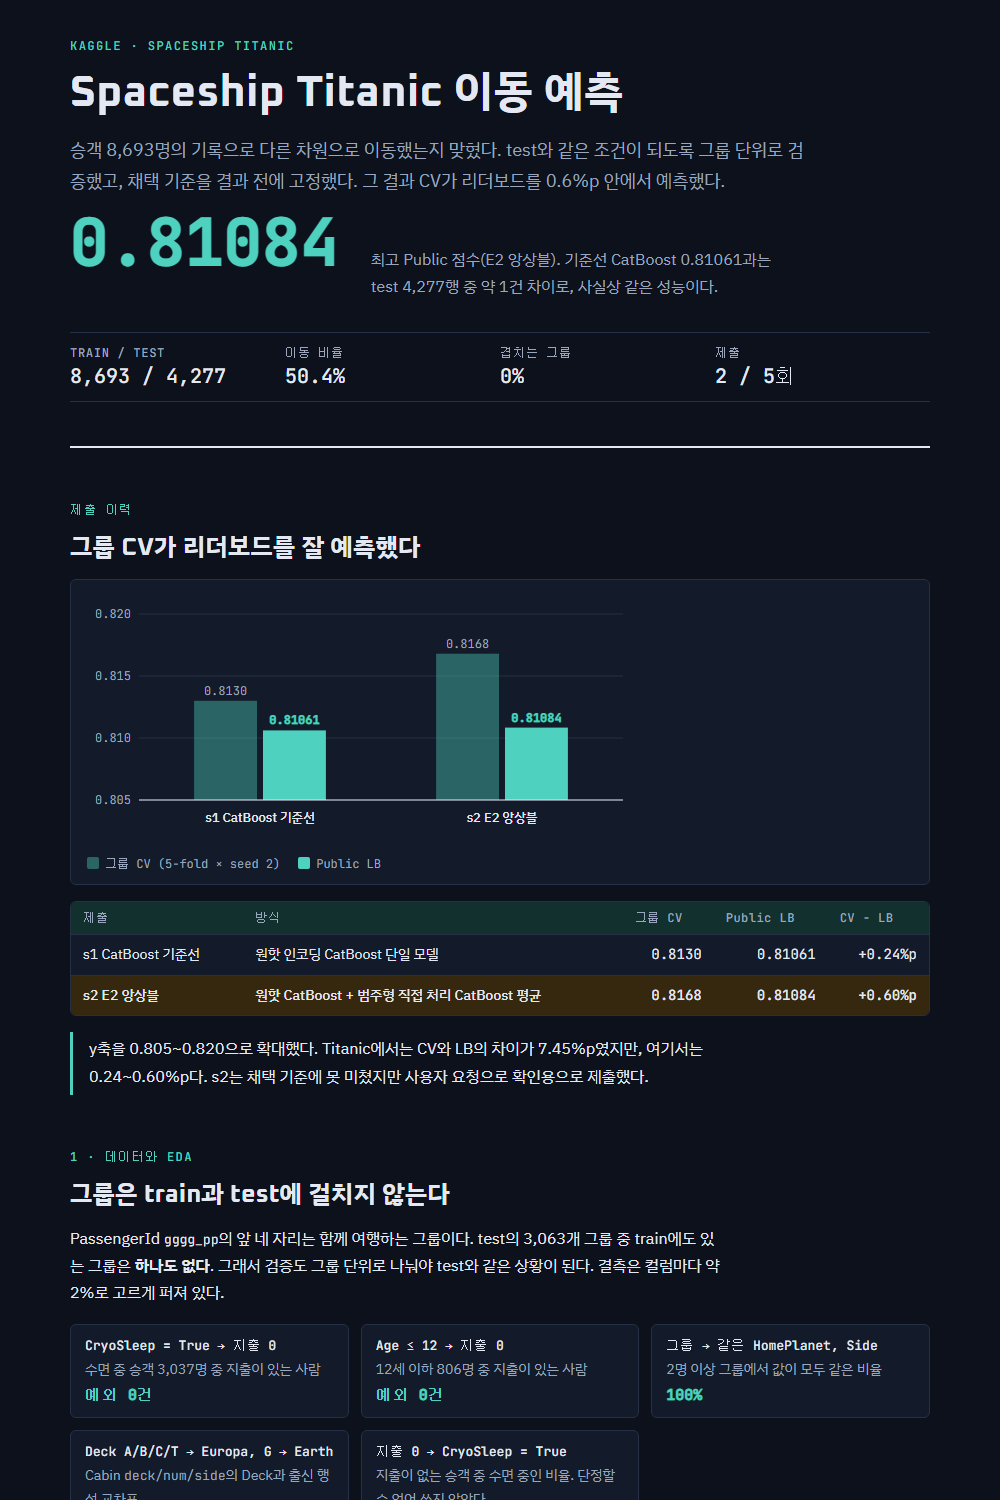
리포트: spaceship/reports/spaceship_report.html(게시용), spaceship_report_standalone.html(로컬용). 비공개 Artifact로 게시했다. 공유하려면 페이지의 Share 메뉴에서 권한을 줘야 한다.
민감정보 검사: 사용자명, 로컬 경로, 이메일, 키 이름 0건
20261017_233636_spaceship-report.png — 웹 리포트 첫 화면(어두운 테마로 렌더링): 최고 점수, 제출별 CV와 LB, EDA 규칙20261017_233650_spaceship-notebook.png — 노트북 HTML: 단계 요약표와 첫 실행 셀
PHASE 10
GitHub Pages 공개
목적작업 기록과 웹 리포트를 누구나 브라우저로 볼 수 있게 GitHub Pages에 게시한다. 공개되는 파일에 민감정보가 없음을 먼저 확인한다.
결과공개 저장소에 공유용 파일만 게시. 모든 페이지 HTTP 200
2026-10-17 23:39 → 23:47 (KST)
#018 웹 리포트와 history를 GitHub Pages로 공개
설정·환경기록·문서화
지시 (원문)
웹 리포트 및 history를 github pages 에서 볼 수 있도록 해줘.
분석
history.html과 두 대회의 웹 리포트를 공개 웹 주소로 볼 수 있게 하라는 지시다. 무료 계정의 GitHub Pages는 공개 저장소가 필요하므로, 올린 파일은 누구나 볼 수 있다.
그래서 프로젝트 전체가 아니라 공유용 파일만 따로 모아 올린다. Kaggle 데이터(대회 규정상 재배포 불가), 코드, .env, 제출 파일은 넣지 않는다.
올리기 전에 모든 공개 파일을 민감정보 검사한다. 기존 검사에 로컬 경로와 OS 사용자명 검사를 더한다.
과정
설정·환경23:39gh CLI가 설치돼 있고 로그인돼 있음을 확인했다(계정 정보는 기록하지 않음).
기록·문서화23:41tools/build_site.py를 작성했다. history.html, history_img, 두 리포트(standalone)와 첫 화면 index.html을 site/에 모은다. 그다음 공개 파일 전체를 검사한다. 리포트에 넣은 base64 이미지는 오탐을 막으려고 검사 전에 지운다. 의심 항목이 하나라도 있으면 종료코드 1을 내고 올리지 않는다.
기록·문서화23:42검사 결과 파일 23개에서 의심 항목은 0이었다. 로컬 경로 패턴은 일부러 넣은 예시로 실제로 걸리는지 확인했다. 외부 링크도 눈으로 확인했다. 비공개 Titanic 리포트 링크 하나만 있었고, 민감정보는 아니다(다른 사람은 열 수 없음). 성공
설정·환경23:43site/만 별도 git 저장소로 만들어 공개 저장소에 push했다. Pages를 main 브랜치 루트로 켰다.
설정·환경23:44Pages 빌드 상태 built. 첫 화면, history, 두 리포트, 증거 이미지 모두 HTTP 200을 받았다. 실제 주소의 첫 화면을 캡처했다. 성공
기록·문서화23:46이 항목을 추가하고, 사이트를 다시 만들어 최신 history를 반영해 push했다. CLAUDE.md에 갱신 절차를 적었다.
판단
최종 판단 (Claude): 사용자가 공개 게시를 직접 지시했다. 그래서 공유용 파일만 담은 별도 저장소로 진행했다. 공개 주소에는 GitHub 계정 이름이 들어가므로 이 기록에는 적지 않고 CLAUDE.md에만 적었다.
앞으로 사이트를 갱신(push)하는 것도 공개 작업이다. 사용자가 요청할 때만 하고, 매번 build_site.py 검사를 통과해야 한다.
결과 / 증거
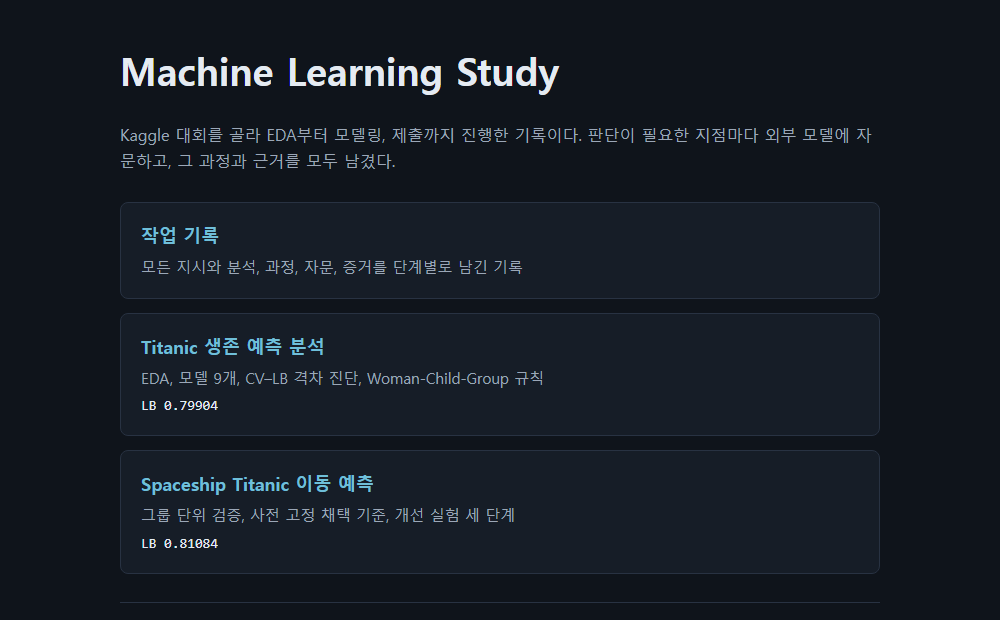
공개 파일: index.html, history.html, history_img/, titanic/report.html, spaceship/report.html (데이터·코드·키 없음)
검사: build_site.py OK(의심 항목 0). 배포: Pages 빌드 built, 페이지 5개 HTTP 200
20261017_234452_github-pages-index.png — 실제 공개 주소의 첫 화면(어두운 테마로 렌더링): 작업 기록과 두 리포트로 가는 링크